清华大学:只用1道题训练大模型,效果接近上万条数据集?颠覆OPD后认知
- 2026-11-18 04:44:44
导语
现在Qwen3、DeepSeek‑V4、GLM‑5等一大批主流大模型,在后训练阶段都在用**OPD(在线策略蒸馏,On‑Policy Distillation)**做能力蒸馏,把强教师模型的推理能力“教”给小学生模型。
行业普遍默认:想要效果好,就得堆海量高质量训练Prompt。但清华这篇重磅论文抛出了反常识结论:
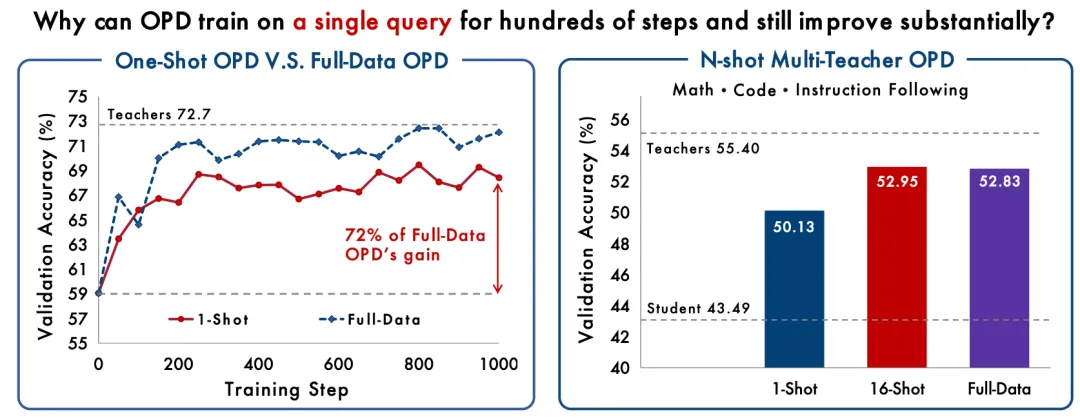
OPD训练,哪怕只给1个问题,反复训练几百步,居然能拿回全量数据集72%以上的性能增益;仅需要16条语义多样化样本,就可以完全追平上万条数据训练结果。
更颠覆的是:甚至不需要正经题目,简单模板、闲聊对话,都能拿来做OPD训练。
OPD不是缺数据,而是数据喂得很饱,但是算法“消化太慢”(data‑overfed but algorithm‑starved)。
先搞懂:什么是OPD?
很多人熟悉GRPO/RLVR强化学习:模型生成完整答案之后,只拿到一个最终打分奖励,对中间每一步思考过程没有指导。
OPD不一样:
学生模型自己生成回答(rollout); 强大的教师模型,对生成过程里每一个token、每一步中间思考,都给出详细概率分布监督信号; 学生不断对齐教师每一步的输出分布,修正思考路径上的错误,而不是只看最终答案对不对。
简单比喻:
RLVR(GRPO)像考完试只告诉你总分,不知道哪一步错; OPD像老师盯着你做题,每写一步,立刻纠正你这一步的思路。
正因为这种逐token稠密监督,OPD现在已经成为工业界推理模型后训练的核心方案。过去研究大多聚焦算法本身,很少追问:到底需要多少训练数据?
于是研究者做了极限压力测试:只拿1道题,给OPD反复训练几百上千步,看看模型会发生什么。
惊人现象:One‑Shot OPD,一道题训到底
实验横跨数学、代码生成、指令遵循、工具调用四大任务,测试Llama、Qwen、OLMo三类不同模型家族,结果高度一致:
✅ 仅仅单个Query训练数百步,数学任务可以拿到全量OPD约72%收益; ✅ 哪怕这道题模型从头到尾根本做不对(hard样例),照样可以大幅提升通用测试集效果; ✅ 不管题目简单、困难,采样温度高低、输出长短,这个现象都稳定存在; ✅ 不止数学:代码、指令遵循、智能工具调用,单样本也能拿回64%‑73%教师‑学生能力差距; ✅ 16条语义足够多样化的Prompt,状态覆盖率达到98.9%,性能和17000条样本训练几乎没有差别。
划重点:不是记住这道题答案,而是在完全没见过的MATH‑500、AMC竞赛测试集上面,泛化能力大幅上涨。
多教师OPD(MOPD)同样成立
现在工业界流行MOPD,一个学生模型同时对接数学、代码多个不同领域专家教师。 实验证实:每个领域只要16条语义多样样本,即可匹敌全量多教师训练,不需要成千上万条领域数据。
核心揭秘:OPD学的不是“题目”,是“思考状态”
为什么一道题就能爆发出巨大训练收益?论文提出核心概念状态覆盖率 State Coverage。
状态(state) = 输入Prompt + 已经生成出来的半截回答
模型每往下生成一个token,就进入一个新状态。OPD真正学习单元不是“一道题”,而是成千上万的思考状态。 同一个题目,每次采样生成不一样的推理路径,会产生大量完全不同的中间状态,每一个状态,教师都会给出稠密监督信号。
单Query经过大量rollout采样,就已经可以覆盖全量数据OPD访问全部思考状态的71.5%,而且大部分在前100步就已经完成; 后续再多训练,新增状态极少; 增加语义不一样的Prompt,才能打开全新状态空间;如果只是换表述但语义相似,几乎不会带来提升。
通俗理解:一道数学题,模型会试各种各样的解题分支,很多分支和做别的数学题时的中间思考高度相似。OPD就在这些通用思考状态上完成能力迁移。
真正瓶颈:算法“消化速度”,而不是数据多少
最关键发现来了: 无论你给模型1条、4条、16条,还是一万七千条数据,学生模型吸收教师监督信号的速率下降曲线几乎一模一样。
每一轮更新,能够消除的师生差距比例(吸收率 absorption rate)持续衰减。哪怕把训练状态完全固定不变,不给任何新状态,模型依旧需要数百步,慢慢消化已有监督。
👉 结论:
OPD是“数据过量供给,但算法饥饿”(data‑overfed, algorithm‑starved)数据很快就能提供足够丰富监督;限制性能上限,不是样本数量,而是模型参数本身消化这些监督信号有多快。
更加反常识:甚至不需要“正经题目”
既然OPD的Prompt本质只是一个**“状态生成器”**,目的只是启动模型思考,把模型带入各种各样推理状态,那是不是不一定需要完整高质量题目?
作者继续做极限测试:
空白思考模板,几乎没有任务内容; WildChat真实互联网闲聊对话,绝大部分和数学代码毫无关系。
结果:这些非任务原生输入,依然可以驱动OPD拿到接近真实训练集的效果。当然效果会轻微下降一点,但差距并不大。
这并不代表高质量样本完全没用。它告诉我们一件事:OPD数据价值,不只看题目写得好不好,更要看这个Prompt能诱导模型进入多少有价值的推理状态。
OPD vs One‑Shot RLVR:两者本质区别
同样是单样本训练,RLVR(GRPO)和OPD行为差异巨大:
RLVR(GRPO):依赖最终结果奖励。当模型把这道题做对概率接近100%,不同样本之间结果趋同,奖励信号直接枯竭,很难继续学习。 OPD:不在乎最终答案对错。哪怕题目已经做对,每一步token仍然有稠密教师分布监督,训练信号持续存在。
同等条件1000步训练,OPD从同一个Query拿到的泛化增益,是RLVR两倍以上。
对工业界大模型训练的启示
这篇论文会改写我们对OPD后训练的数据策略认知:
不要盲目堆数据量,优先追求“状态多样性”不是越多Prompt越好,重点挑选那些能够诱导出全新推理状态的样本。16条语义多样样本 > 上千条语义重复样本。
数据集构建思路转变:从“收集好题目”变成“收集能够触发丰富思考状态的输入”未来数据筛选指标,除了正确率、难度,还可以评估输入能打开多大状态覆盖。
OPD真正短板是步效率现在大量算力消耗在重复训练步骤上,不是缺监督信号,而是模型学得慢。未来研究方向是:如何提升监督信号的吸收速率,减少训练步数。
多教师MOPD场景,每个领域不必囤积海量数据,只要保证每个领域少量语义多样化Prompt即可。
⚠️ 论文也指出局限性: 状态覆盖率是一个相对指标,基于全量运行的状态参考集合;目前实验主要集中中小参数量模型,更大模型上行为还需要进一步验证。
写在最后
过去大模型后训练,大家惯性思维:“效果不好,就多堆高质量数据”。 这篇论文告诉我们:要看清算法到底在消费什么。OPD消费的不是Prompt文本本身,而是Prompt触发出来的千千万万思考状态。
当算法本身消化能力成为瓶颈,盲目增加样本,收益会非常有限。

