ICLR 2026 | 德语训练的模型,英语题答得比英语训练的还好:RL 跨语言泛化的反直觉实验
- 2026-11-20 03:03:53
用 RL 刷推理已成标配,但整个社区默认一件事:训练数据用英语——毕竟主流模型的预训练语料以英语为主,英语数据最能激发模型潜力。
浙大和西湖大学这篇 ICLR 2026 论文把这个默认假设拿出来做了首次系统检验,结论相当反直觉。RL 的跨语言泛化能力全面碾压 SFT:MGSM 十种语言上,RL 平均比 SFT 高 17 到 25 分,泛化得分差距更大。
更意外的是,用德语、中文做 RL 训练,最终效果反超用英语训练——德语训练的模型十种语言平均 71.5 分,英语训练只有 62.7,而这个现象在 SFT 里完全不存在。
机制分析给出三条线索:RL 模型会自发混用语言推理,强制语言一致性能把分数从 61.4 打到 52.0;采样加在线优化是泛化的引擎;训练后的语义漂移越小,跨语言泛化越强。三个基座模型上全部复现。
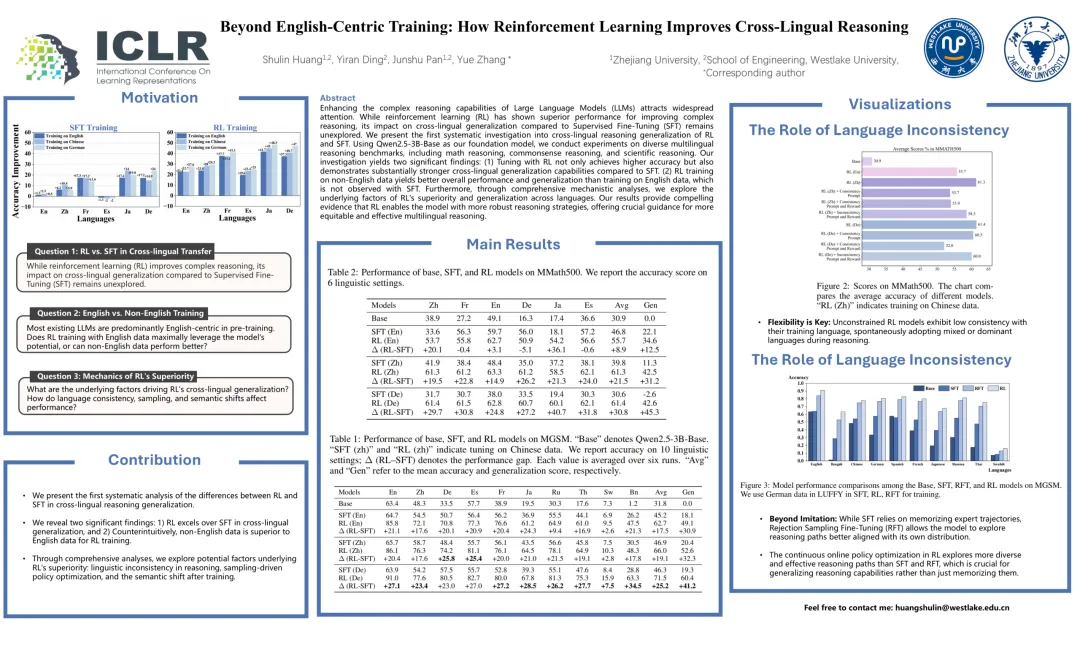
实验设计:三基座、十种语言、七类推理基准
实验的舞台搭得很规整。基座模型选 Qwen2.5-3B-Base,另用 SmolLM3-3B 和 Qwen2.5-7B 复现;训练数据是 GSM8K 与 LUFFY 的机翻版本,每语言八千到四万五千条,翻译由大模型完成再经校验,质量与公开多语言数据集打平。评测铺到十种语言——英中徳西法俄日泰斯瓦希里孟加拉——和七类基准:数学、常识、科学、逻辑、指令遵循。
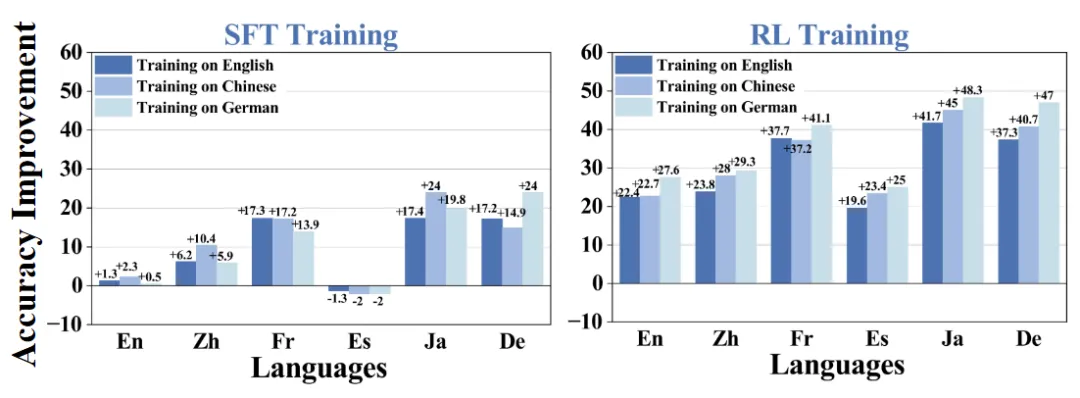
Figure 1 : SFT 与 RL 用英中德三种数据训练后的各语言提升对比,RL 提升幅度与均衡性全面占优
方法对比就是朴素的 SFT 对 GRPO,统一三 epoch、全参数微调。为了公平衡量"涨分潜力",作者定义了泛化得分:每个语言先对基座做归一化提升,再跨语言取平均。 Figure 1 已经透露了全文走向——左边 SFT 的柱子参差不齐、跨语言迁移忽高忽低,右边 RL 的柱子整齐地全面上扬。
发现一:RL 跨语言泛化碾压 SFT
MGSM 十分位成绩单是全文最直观的一张表。基座平均 31.8 分;SFT 之后摸到 45 分上下;RL 直接拉到 62.7 起步。逐语言看差距:RL 相对 SFT 的提升从 9.4 分到 34.5 分,平均分差 17.5 到 25.2,泛化得分的差距进一步放大到 30 分以上。
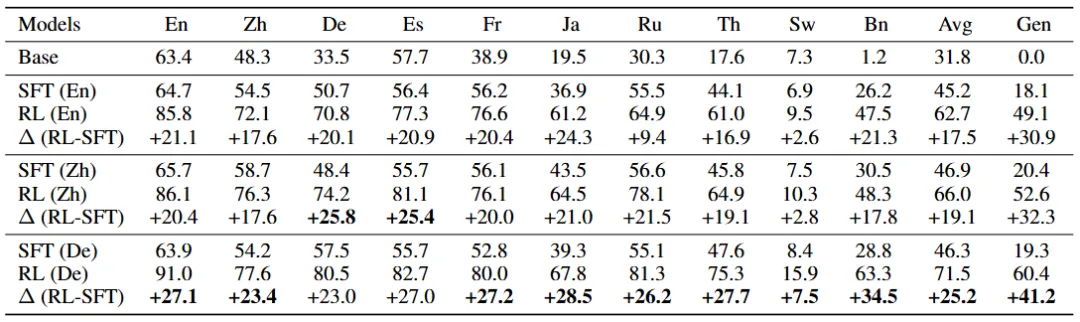
Table 1 : MGSM 十种语言成绩总表:RL 全语言超 SFT,德语训练的泛化得分 41.2 为全场最高
泛化的真正试金石是低资源语言。用中文数据训的 RL 模型,在德语上比 SFT 高 25.8 分,在西班牙语上高 25.4 分;用德语训的模型对孟加拉语的提升达到 34.5 分。MMath500 复现同一趋势,RL 比 SFT 平均高 21.5 分。
更值得注意的是任务迁移:常识与科学基准上,SFT 经常出现负迁移——MGPQA-D 上 SFT 的泛化得分是负 13.9,RL 保持正 7;德语数学数据训出的模型,在中文常识题上还比 SFT 高 20 分,语言与任务双重跨域依然成立。
发现二:非英语数据反超英语,SFT 无此现象
反直觉的主菜在这。把训练语言换成中文、德语,RL 的平均分不降反升:德语 71.5、法语 70.7、日语 70.9,全面超过英语训练的 62.7。德语训练的模型在英语评测上拿到 91.0,比英语训练模型的 85.8 还高出 5 分有余;对孟加拉语和泰语,德语训练分别比英语训练高 15.8 和 14.3 分。
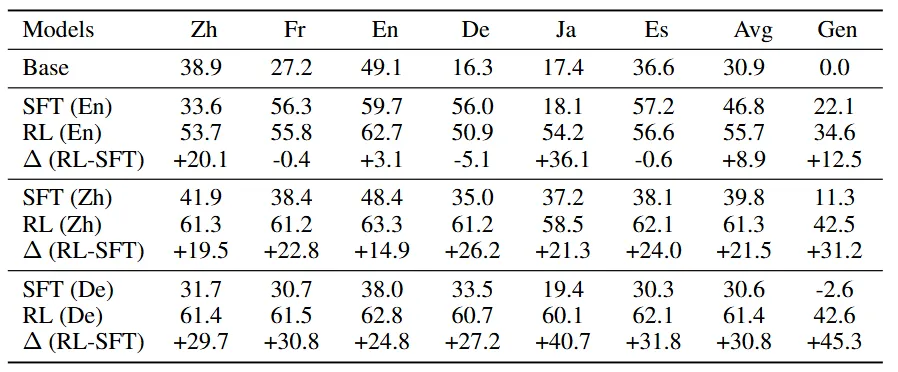
Table 2 : MMath500 六语言成绩:RL 中德语训练平均 61.3 与 61.4,远超英语训练的 55.7
两个对照实验排除了替代解释。一是 SFT 侧完全没有这个效应——无论用什么语言训,SFT 的平均分都停在 46 到 47 之间,说明这不是德语数据质量更好。二是混合语言训练也不行——英中德混合的 RL 拿到 68.1,仍输给纯德语的 71.5,说明"某种非英语语言"比"多语混合"更能激发泛化潜力。SmolLM3 和 7B 基座上,两个发现原样复现,排除了模型特例。
机制一:语言不一致是 feature,强制一致性能打崩分数
机制排查从一条观察开始:德语训练的模型几乎从不用德语推理——它对德语题和中文题的回答语言一致性都是 0.0%,推理过程自由地混用英语、德语甚至更多语言。作者随后做了手术式干预:用提示词强制模型用训练语言作答,或在奖励里加语言一致性项。
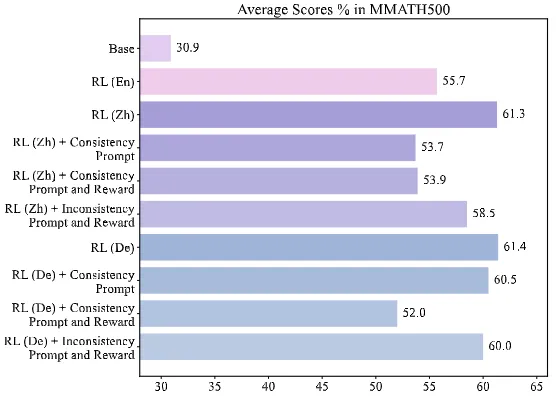
Figure 2 : 语言一致性干预实验:强制德语推理加一致性奖励后平均成绩从 61.4 跌至 52.0
结果干脆得近乎残酷。中文训练的模型从 61.3 掉到 53.7;德语训练的模型加一致性奖励后跌到 52.0。而鼓励不一致的干预能回涨一部分,但最好的成绩永远是"什么都不约束、让模型自己选语言"。
案例对比更直观:同一道德语应用题,混用语言推理的模型条理清晰算出 78,被强制只说德语的模型反而逻辑错乱给出 76。SFT 模型的一致性高达九成九,恰恰被锁死在训练语言的模式里——一致性在 SFT 是模仿的副产品,在 RL 却是自由的代价,而自由更值钱。
机制二:采样与在线优化是泛化引擎
第二个机制用拒绝采样微调 RFT 当探针。RFT 从模型自己采样、只留答对的做微调,比 SFT 更贴合模型分布,但仍是离线模仿。MGSM 上的递进链条很清楚:SFT 平均 46.3,RFT 66.8,完整 RL 71.5——每一步提升都对应"数据更贴模型分布"加"优化方式更在线"。
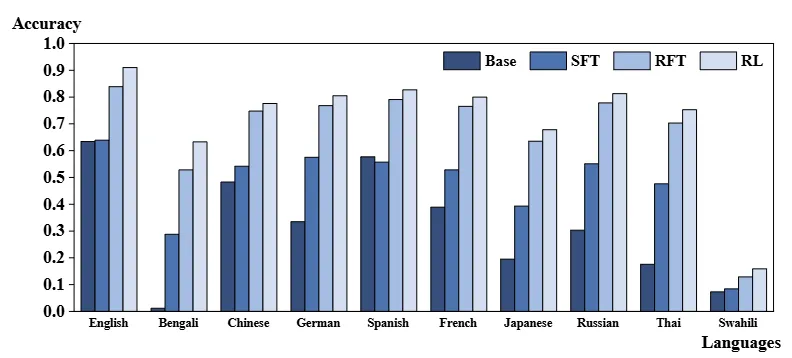
Figure 3 : 基座、SFT、RFT、RL 四级递进:平均 46.3 到 66.8 到 71.5,在线优化再进一步
为什么偏偏是德语数据最能激发这种探索?答案藏在基座模型的不确定性里:德语题目的采样困惑度最高、自相似度最低——模型面对德语时最"没把握",RL 的探索阶段被迫跳出单一语言的舒适区,在混用语言的路径里试错,反而激活了更强的跨语言推理模式。
英语困惑度最低,采样被锁定在英语模式内,探索多样性天然受限。这也顺带解释了 SFT 的平庸:它紧贴训练数据的语言分布,连探索的机会都没有。
机制三:语义漂移越小越好,德语训练漂移最稳
第三条机制看表征层。作者把 RL 训练后与基座模型的末层隐状态做差,投影到二维平面。德语训练的模型差异向量最密集地挤在原点附近——表征几乎没动;英语训练的模型分布最散。给德语模型加强制性干预,散度跟着变大,与性能下跌一一对应。
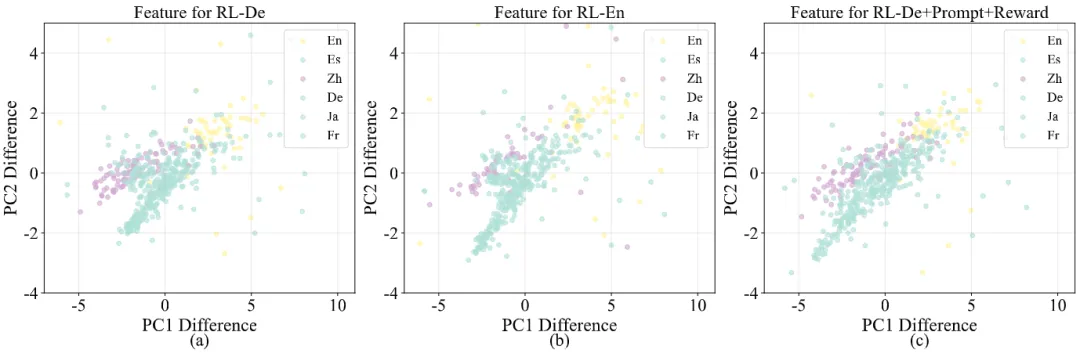
Figure 4 : 隐状态差异向量的 PCA 投影:德语训练的漂移最集中,英语训练最分散
解读是:预训练已经建立了跨语言共享的推理结构,微调时动得越少,这套通用结构保留得越完整,跨语言迁移就越强。RL 的语言混用恰好是最省力的推理路径——模型不需要为每种语言单独重构表征,绕开了大漂移对通用推理机制的破坏。
三条机制在此收拢成一句话:RL 的优势不在学得更多,而在动得更少、探索得更自由。
结语:先 SFT 再 RL,可能反而是绊脚石
最后一个实验给工程实践提了个醒。社区流行的冷启动配方——先 SFT 再 RL——在这套多语言设定下反而拖后腿:SFT 加 RL 的组合只拿到 52.6 的平均分,直接 RL 是 71.5。作者的解释是 SFT 让模型过早收敛进特定语言的模式,锁死了 RL 的探索空间。
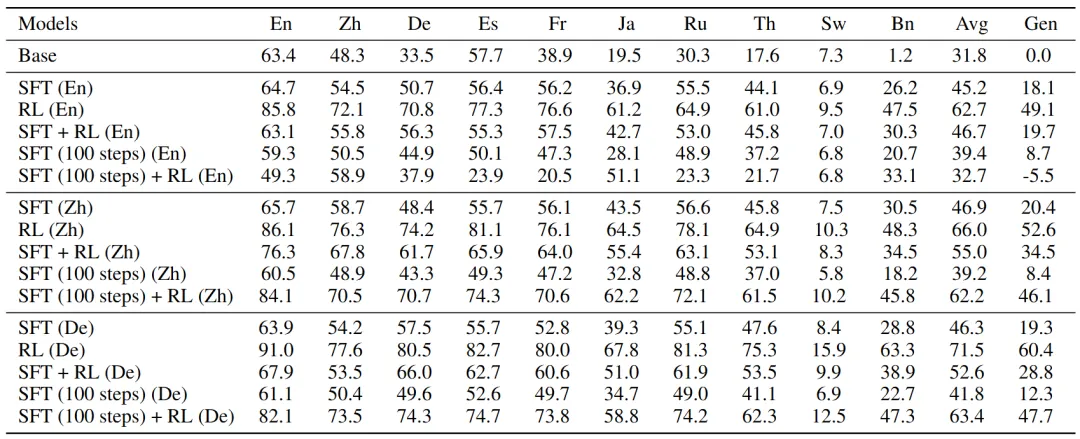
Table 15 : 冷启动对比:先 SFT 再 RL 的泛化得分 28.8,直接 RL 为 60.4,SFT 限制了探索
这项工作最值钱的地方不是某个分数,而是把"英语中心"从公理打回假设。对绝大多数非英语使用者占多数的场景——教育、客服、本地服务——用目标语言做 RL 训练,可能比费劲收集英文数据更划算。
局限也坦白:机制分析仍是初步的,语言不一致、采样、表征漂移三条线索如何咬合,还需要更精细的因果检验。但至少下次有人默认"用英语训 RL",这篇论文值得先被翻出来。
持续关注本公众号【赛博雷达】,我们会第一时间拆解更多前沿开源模型、本地AI实战和Agent最新进展。喜欢这篇文章就点个关注+转发给正在专注AI的朋友,把这份思考分享给更多AI爱好者。
感谢阅读,我们下期见~

