移动通信系统实验期末考试复习
- 2026-11-06 21:57:23
移动通信系统实验期末考试复习
一、考试究竟考哪几类题目?
根据考试要求,考试为开卷形式,但不能使用电子设备;现场会提供协议,要求考生根据协议答题。题目主要分为发射机和接收机两大部分。
发射机部分侧重模块技术细节、协议理解和手算;接收机部分侧重自己设计的算法、代码理解、计算思路、流程图和伪代码。
1. 发射机(Transmitter)
重点是协议理解、模块原理和手算。
·CRC 校验与生成:CRC24A、CRC24B、CRC16、CRC8 的区别,生成多项式、模2除法和校验位计算。
·码块分割(Code Block Segmentation):最大码块长度6144 bit、码块数量、K+ / K−、填充比特F及填充位置。
·Turbo编码与速率匹配:Turbo编码器结构、三个输出比特流、32列子块交织矩阵、虚假比特填充和速率匹配的作用。
2. 接收机(Receiver)
重点是算法理解、代码分析、计算思路、流程图和伪代码。
·时间同步与频率同步:CP同步、DMRS同步、小数频偏和整数频偏的估计与补偿。
·信道估计与补偿:利用导频估计信道、线性插值、迫零均衡(ZF)和最小均方误差均衡(MMSE)。
·解调与性能评估:64QAM解调、硬解调与软解调、SER计算,以及SNR与误码性能的关系。
补充:Exp.02中的码块级联、信道交织和加扰,以及Exp.03、Exp.04中的导频生成、资源映射和OFDM成帧,也可能作为发射机模块的补充考点。Exp.02课件将码块级联、信道交织和加扰标注为选做,复习时可放在第二优先级。
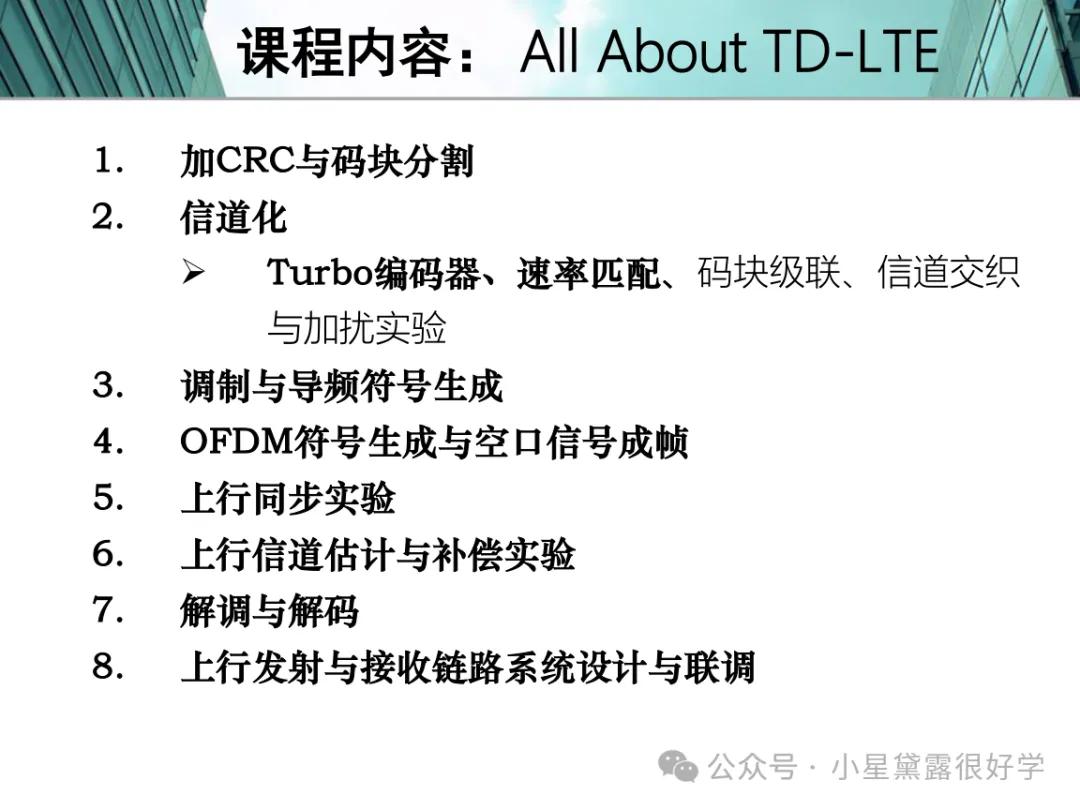
图1 课程内容总览(来源:Exp.00,第3页)
二、发射机和接收机的完整流程
可以把整门实验课理解为:发射机负责把数据处理成可以通过无线信道发送的信号;接收机负责把收到的无线信号尽可能准确地恢复成原始数据。
1. 发射机:把数据变成无线信号
原始信息比特(TB):待发送的原始数据,例如一串0和1。
CRC添加:给数据增加校验信息,方便接收端检查是否出错。
码块分割:数据太长时切分成多个较小的码块。
Turbo编码:增加冗余信息,提高抗错误能力。
速率匹配:调整需要发送的比特数量,使其适应无线资源。
加扰与调制:对比特进行加扰,并映射成复数调制符号。
导频生成与资源映射:加入已知参考信号,并安排数据和导频的位置。
OFDM/SC-FDMA成帧:完成频域到时域的转换,并添加循环前缀CP。
最终由天线发送无线信号。
2. 接收机:把无线信号还原成数据
接收无线信号:接收天线获得经过信道的信号。
时间同步:找到正确的信号起始位置。
频率同步:估计并消除发射机和接收机之间的频率偏差。
去CP、FFT:去除循环前缀,并恢复频域数据。
信道估计与补偿:估计信道造成的幅度衰减和相位变化,并进行补偿。
解调:把复数调制符号恢复成比特。
性能评估:计算SER等指标,判断通信质量。
记忆方法:Exp.01–Exp.04主要研究数据如何发出去;Exp.05–Exp.07主要研究如何把数据正确地收回来。
三、发射机模拟题
第1题:CRC24A和CRC24B有什么区别?
题目:LTE系统中为什么需要CRC校验?CRC24A和CRC24B分别是什么?它们的主要区别是什么?
讲解
CRC(Cyclic Redundancy Check,循环冗余校验)可以理解为给原始数据附加一串根据特定规则计算出来的校验比特。接收端重新检查这种数学关系,如果不符合,就说明数据可能发生了错误。
CRC计算基于GF(2)域。模2加减运算都相当于异或(XOR):
0⊕0=0,0⊕1=1,1⊕0=1,1⊕1=0。
CRC24A和CRC24B都产生24 bit校验序列,但生成多项式不同,因此计算结果不同,发送端和接收端必须使用一致的多项式。
CRC类型 | 校验长度 | 说明 |
CRC24A | 24 bit | 使用CRC24A生成多项式 |
CRC24B | 24 bit | 使用CRC24B生成多项式 |
CRC16 | 16 bit | 使用CRC16生成多项式 |
CRC8 | 8 bit | 使用CRC8生成多项式 |
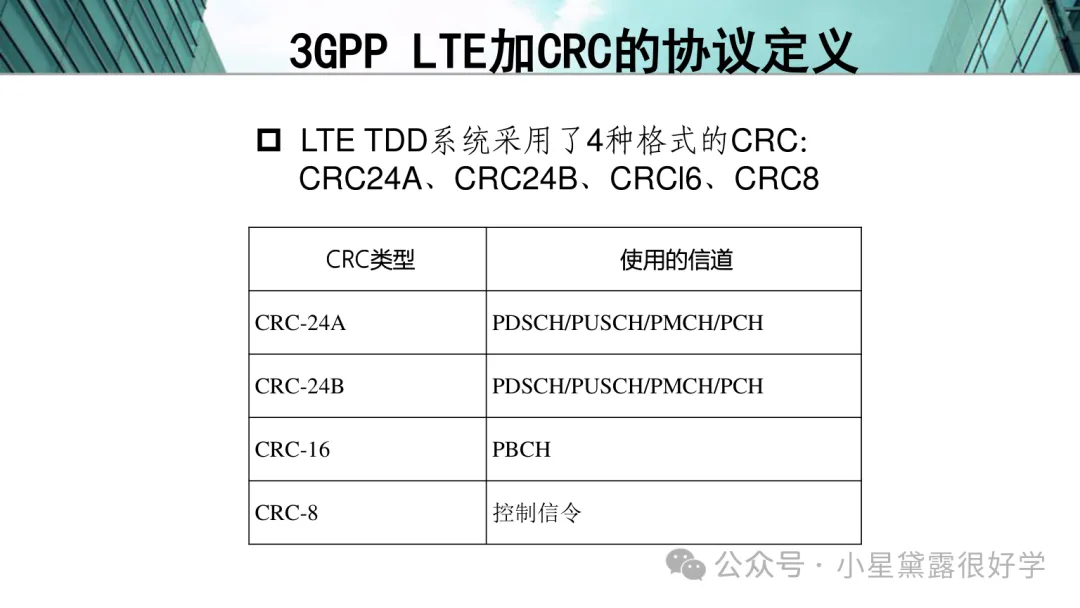
图2 LTE中CRC类型及课件列出的使用信道(来源:Exp.01,第11页)
考试参考答案:CRC是一种差错检测方法,通过在信息比特后附加校验比特,使接收端能够根据特定数学关系判断数据传输过程中是否发生错误。CRC24A和CRC24B均为24位校验码,但使用不同的生成多项式。
第2题:手算CRC校验码
题目:已知信息比特A=1010001101,生成多项式G=110101,计算CRC校验码。
计算步骤
① 生成多项式长度为6,因此阶数L=6−1=5。
② 在原始信息后补5个0:101000110100000。
③ 使用110101作为除数进行模2长除法,每一步用异或代替普通减法。
④ 最终余数为01110,即CRC校验码。
最终传输序列:1010001101 01110
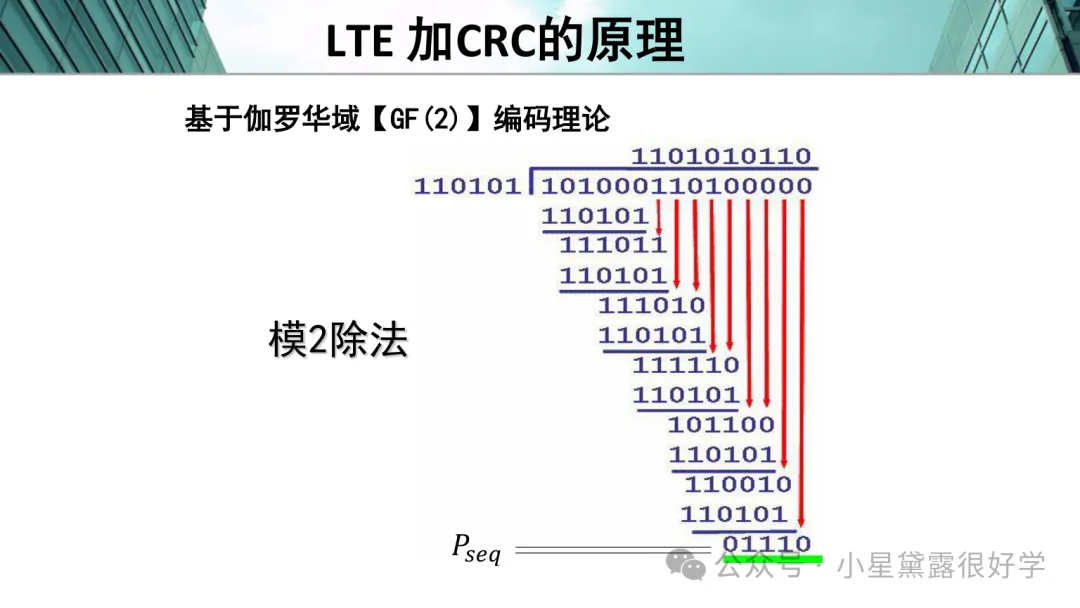
图3 CRC模2除法示例(来源:Exp.01,第8页)
记忆方法:生成多项式的阶数决定补零个数;模2除法得到余数;将余数接到原始信息后面。
注:以上示例结果按课件中的CRC模2除法图示整理。
第3题:70000 bit数据如何进行码块分割?
题目:已知经过TB CRC添加后的输入数据长度B=70000 bit,LTE规定最大码块长度Z=6144 bit,每个码块添加24 bit CRC。求码块数量、大小码块长度、填充比特数及矩阵大小。
计算思路
① 每个码块最多承载的原始数据量为6144−24=6120 bit。
② 码块总数:C=ceil(70000/6120)=12。
③ 按本题所采用的码块长度表,取K−=5760、K+=5888。
④ 加入码块CRC后的总长度:B′=70000+12×24=70288 bit。
⑤ 小码块数量:C−=floor[(C×K+−B′)/(K+−K−)]=floor[(12×5888−70288)/128]=2。
⑥ 大码块数量:C+=12−2=10。
⑦ 填充比特数:F=C+K++C−K−−B′=10×5888+2×5760−70288=112 bit。
参数 | 结果 | 含义 |
C | 12 | 码块总数 |
C+ | 10 | 大码块数量 |
K+ | 5888 bit | 大码块长度 |
C− | 2 | 小码块数量 |
K− | 5760 bit | 小码块长度 |
F | 112 bit | 填充比特数 |
按本题计算结果,矩阵为12×5888。按LTE码块分割规则,较大的码块排在前面,较小的码块排在后面;填充比特放在第一个码块的最前面。
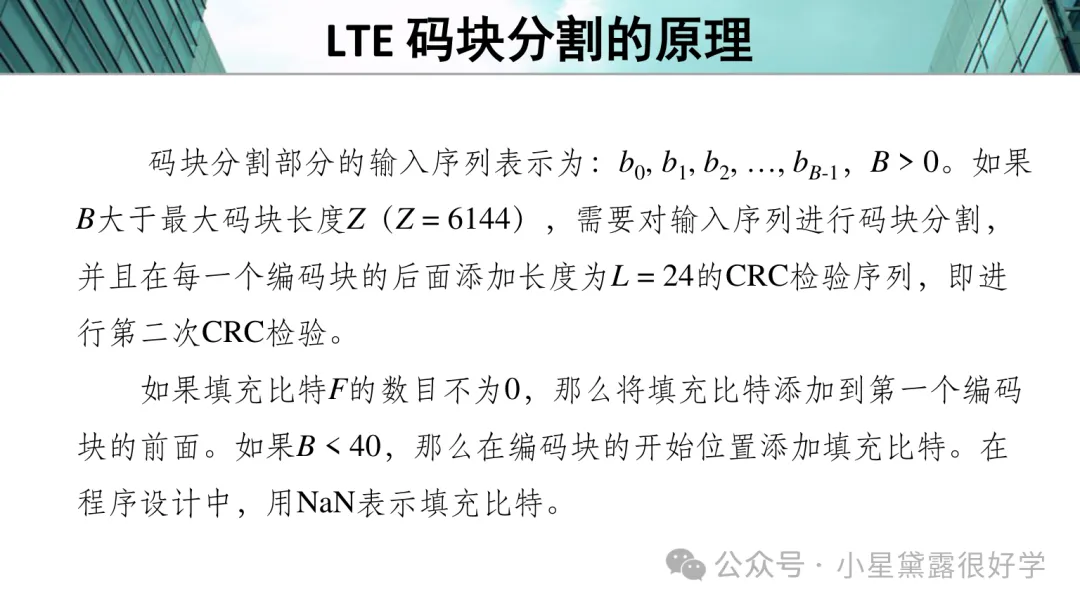
图4 码块分割规则与填充比特说明(来源:Exp.01,第18页)
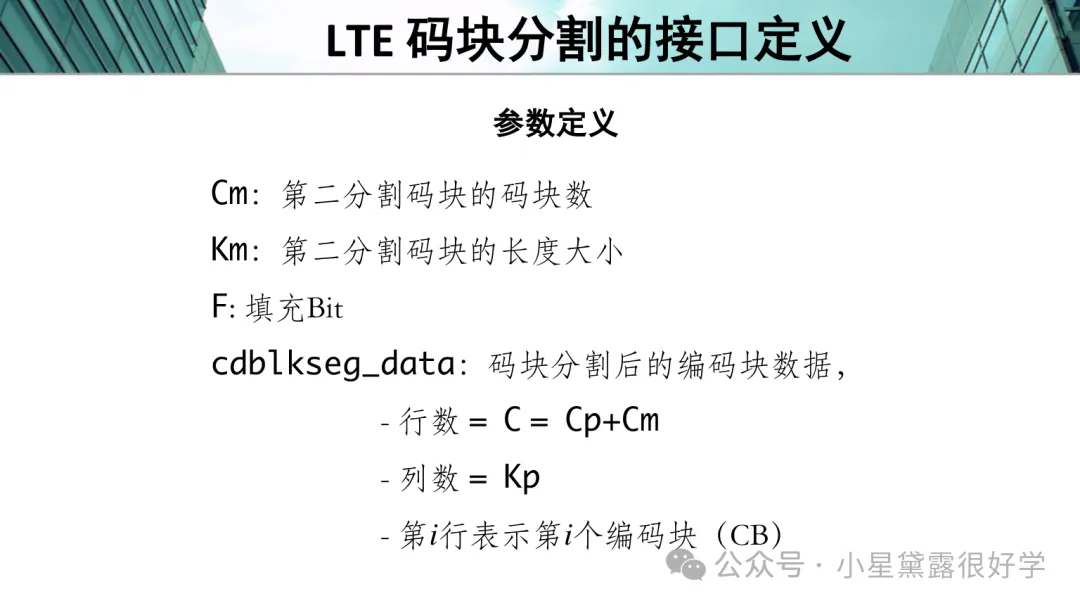
图5 码块分割接口输出参数说明(来源:Exp.01,第23页)
注意:矩阵列数采用最大码块长度K+。小码块行的有效长度较短,不能把矩阵中所有位置都理解成有效信息比特。
第4题:Turbo编码在做什么?为什么输出三个比特流?
题目:LTE Turbo编码器由哪些部分组成?为什么编码速率是1/3?结合MATLAB接口说明处理过程。
讲解
Turbo编码的目的,是在原始信息之外增加冗余信息,让接收端在发生错误时有更多线索进行纠错。
LTE Turbo编码器主要由两个8状态卷积编码器和一个Turbo内部交织器组成。第一个编码器处理原始信息;第二个编码器处理交织后的信息。
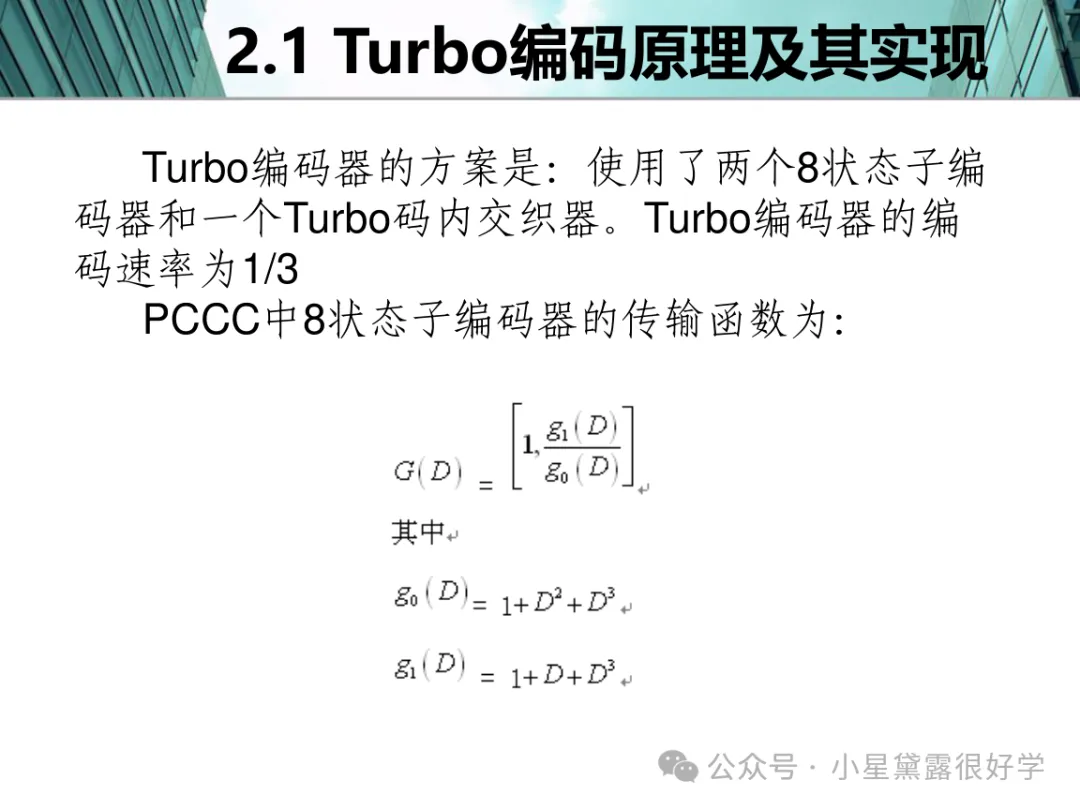
图6 LTE Turbo编码器结构示意(来源:Exp.02,第5页)
编码器输出包括:原始系统比特流、第一路校验比特流、第二路校验比特流。因此,理想情况下每输入1 bit,输出3 bit,编码速率为1/3。
内部交织器会改变第二个编码器所处理的信息排列顺序,使两个编码器从不同排列角度产生校验信息。
课件接口:
codedSym = lte_TurboEncoder(C, cdblkseg_data, Cm, Km, Kp, F);
参数 | 含义 |
C | 码块总数 |
cdblkseg_data | 码块分割后的数据 |
Cm | 第二类码块数量 |
Km | 第二类码块长度 |
Kp | 第一类码块长度 |
F | 填充比特数量 |
codedSym | Turbo编码后的输出 |
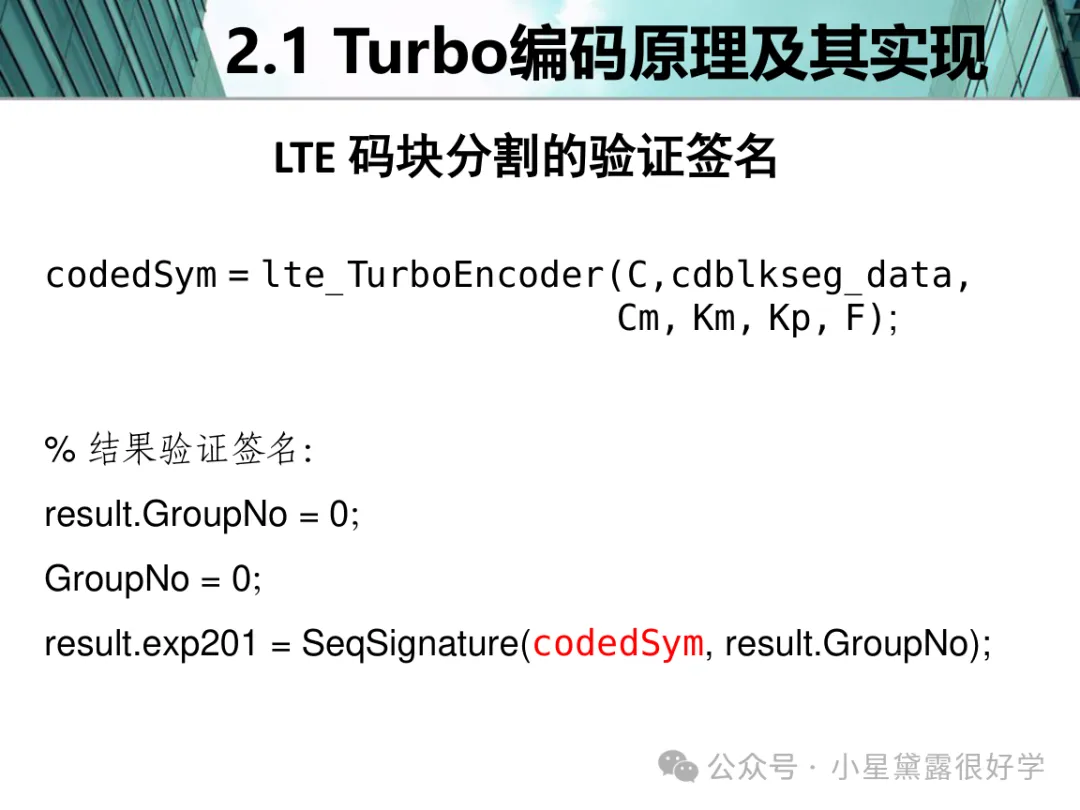
图7 Turbo编码流程框图(来源:Exp.02,第12页)
考试参考答案:LTE Turbo编码采用并行级联卷积码结构,由两个8状态子编码器和一个内部交织器构成。输入数据分别经过两个编码器,其中第二个编码器处理交织后的数据,最终产生一个系统比特流和两个校验比特流,编码速率为1/3。
第5题:速率匹配为什么存在?它和交织有什么区别?
题目:Turbo编码后为什么还需要进行速率匹配?速率匹配和交织分别解决什么问题?
讲解
速率匹配主要解决“数据长度是否适合当前无线资源”的问题。Turbo编码后的比特数不一定刚好等于当前可用资源所能承载的比特数,因此需要通过比特选择、打孔或重复等方式调整输出长度。LTE采用循环缓冲区机制。
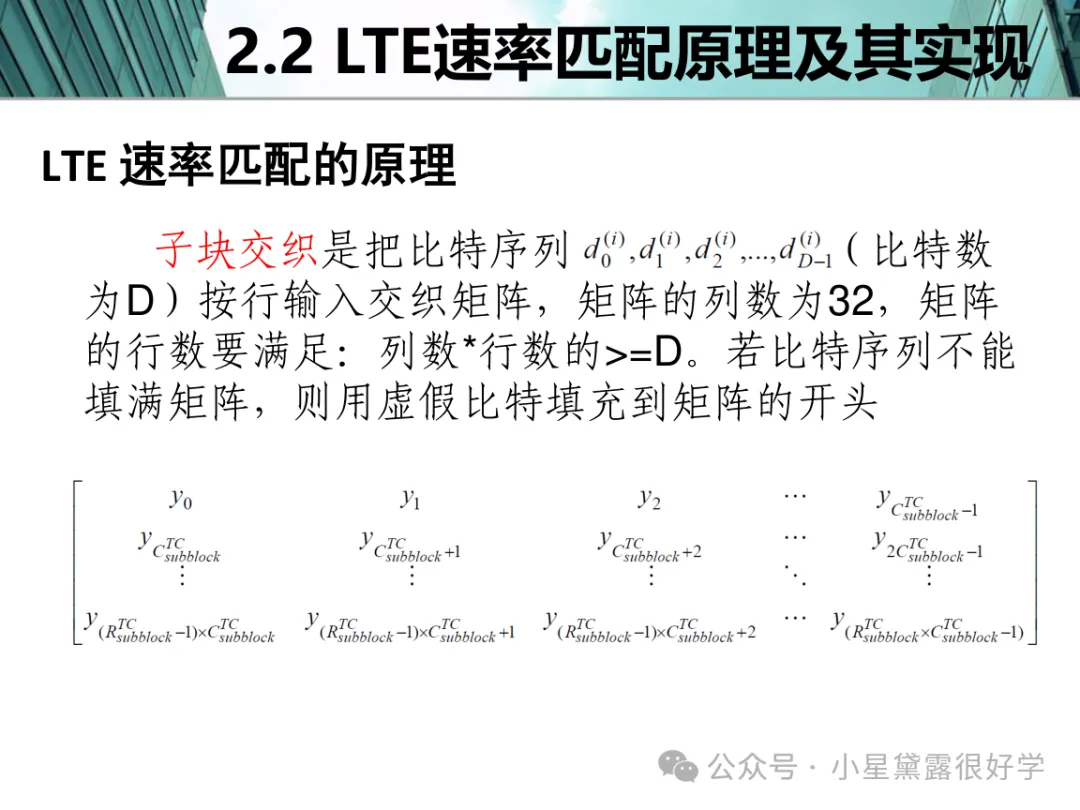
图8 LTE Turbo编码速率匹配流程:子块交织、比特收集和循环缓冲区选择(来源:Exp.02,第17页)
子块交织则主要解决“比特排列顺序”的问题。课件中子块交织矩阵固定为32列,行数需要满足矩阵容量不小于输入比特数;若不能填满矩阵,则在矩阵开头填入虚假比特。
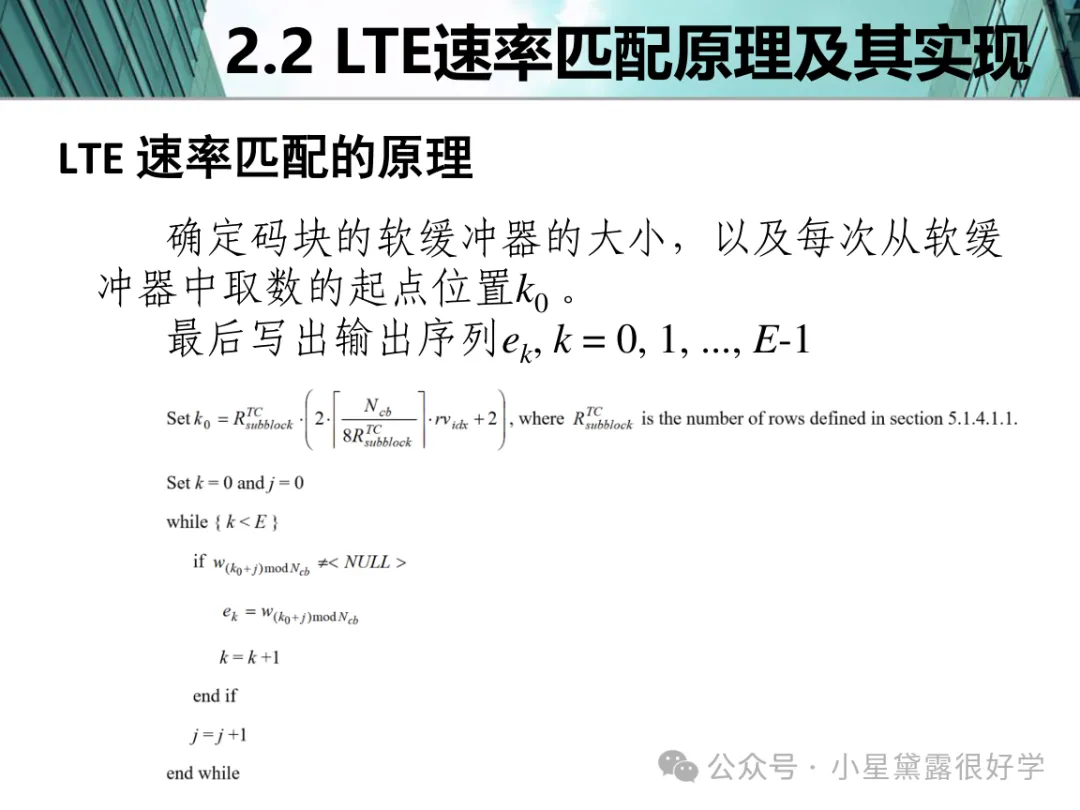
图9 子块交织矩阵结构(来源:Exp.02,第18页)
比较 | 速率匹配 | 交织 |
核心目的 | 调整发送长度 | 改变比特顺序 |
主要操作 | 比特选择、打孔、重复 | 按规则重排 |
解决问题 | 资源容量不匹配 | 分散突发错误 |
接收端处理 | 软信息恢复、重传合并等 | 解交织 |
接口:
[rmSym, rmLen] = lte_RateMatching(codedSym, Channel_type, Nir, C, Cm, direction, module_type, RVidx, Nl, G, Km, Kp);
其中codedSym是Turbo编码输出,G表示一个传输通道所需的总传输bit数,RVidx为冗余版本号,rmSym和rmLen分别为速率匹配后的数据和长度。
考试参考答案:速率匹配根据无线资源和调制方式调整传输比特数量,使编码输出适应实际传输需求;交织通过改变比特排列顺序,将突发错误分散,提高系统抗差错能力。两者目的不同。
四、接收机模拟题
第6题:QPSK、16QAM和64QAM有什么区别?
题目:三种调制方式分别代表什么?每个调制符号可以承载多少bit?
调制就是把一组二进制比特映射成一个复数信号。星座图上的每一个点代表一种可能的复数调制符号。
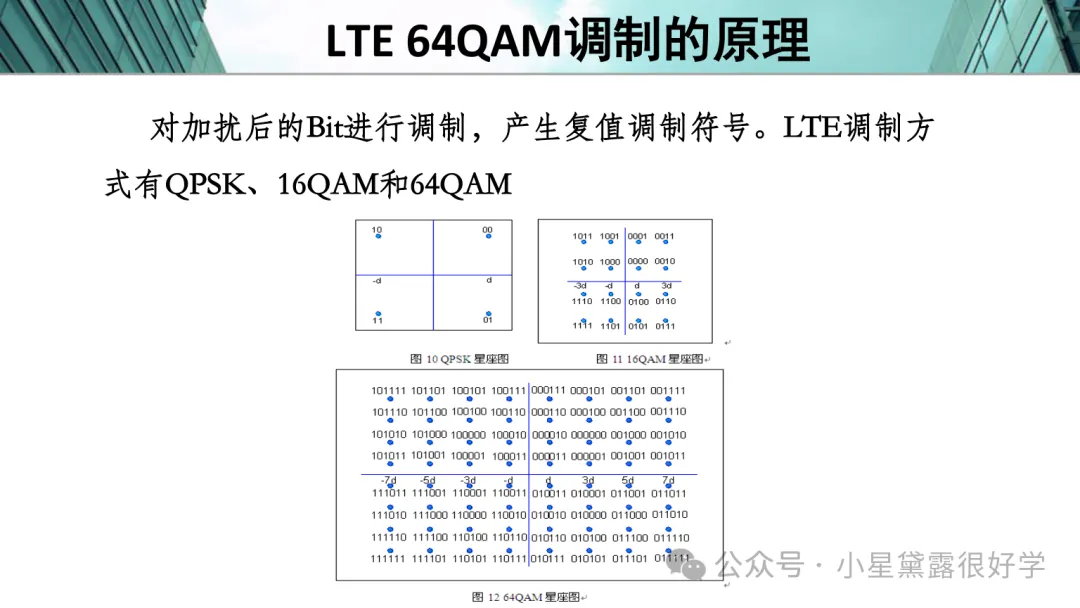
图10 QPSK、16QAM和64QAM星座图(来源:Exp.03,第5页)
每个符号承载的比特数为log₂M,其中M为星座点数。
调制方式 | 星座点数 | 每个符号承载比特数 |
QPSK | 4 | 2 bit |
16QAM | 16 | 4 bit |
64QAM | 64 | 6 bit |
星座点越多,频谱利用率通常越高,但点与点之间的距离更近,对噪声和信道质量更敏感。
接口:Mod_Sig = lte_pusch_modulation(scrmbedSym, prb_num, module_type)。其中module_type=1为QPSK,2为16QAM,3为64QAM。
考试参考答案:QPSK、16QAM和64QAM分别有4、16和64个星座点,每个符号分别携带2、4和6 bit。高阶调制可提高频谱利用率,但对信道质量要求更高。
第7题:导频是什么?为什么需要导频?
题目:LTE上行系统为什么需要生成导频?导频与普通数据有什么区别?
导频(参考信号)是发射端提供给接收端的一种已知信号,用于信道估计或信道探测。接收端将已知的本地导频与接收到的导频比较,就可以估计无线信道造成的变化。
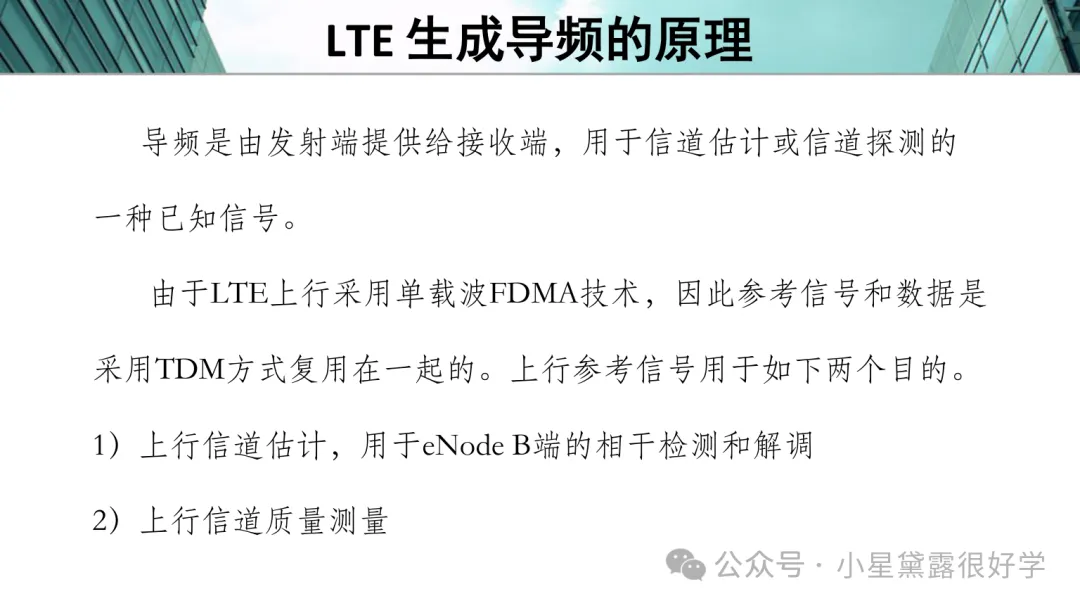
图11 LTE上行参考信号的用途及位置示意(来源:Exp.03,第14页)
课件指出,上行参考信号主要用于信道估计和信道质量测量。LTE上行子帧中有两个DMRS符号,分别位于两个时隙中的指定符号位置。
导频必须是接收机预先知道的信号,才能用于与接收结果进行比较;普通数据则是需要接收机恢复的未知信息。
第8题:一个子帧有多少个符号?为什么还要添加CP?
题目:LTE上行一个子帧包含多少个SC-FDMA符号?数据符号和导频符号分别有多少个?CP有什么作用?
一个子帧包含两个时隙,每个时隙有7个符号,因此一个子帧共14个符号。课件中数据占用12个符号,导频占用2个符号。
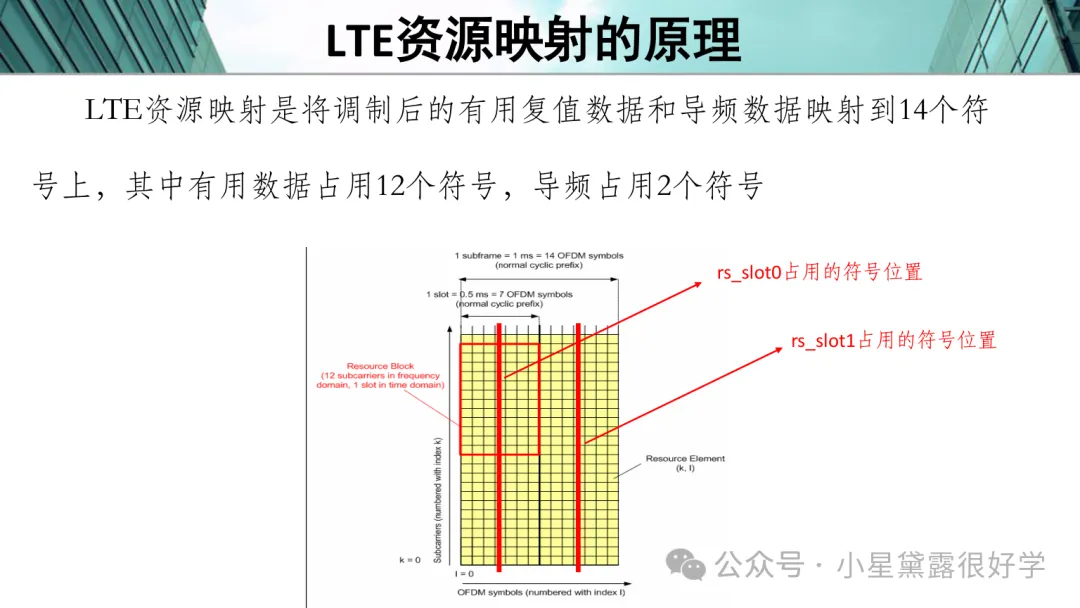
图12 LTE上行资源映射:数据与导频在子帧中的位置(来源:Exp.04,第5页)
CP(Cyclic Prefix,循环前缀)是把一个符号末尾的一段数据复制到符号开头。它可以在满足一定条件时减少多径传播造成的符号间干扰,并帮助维持子载波正交性。
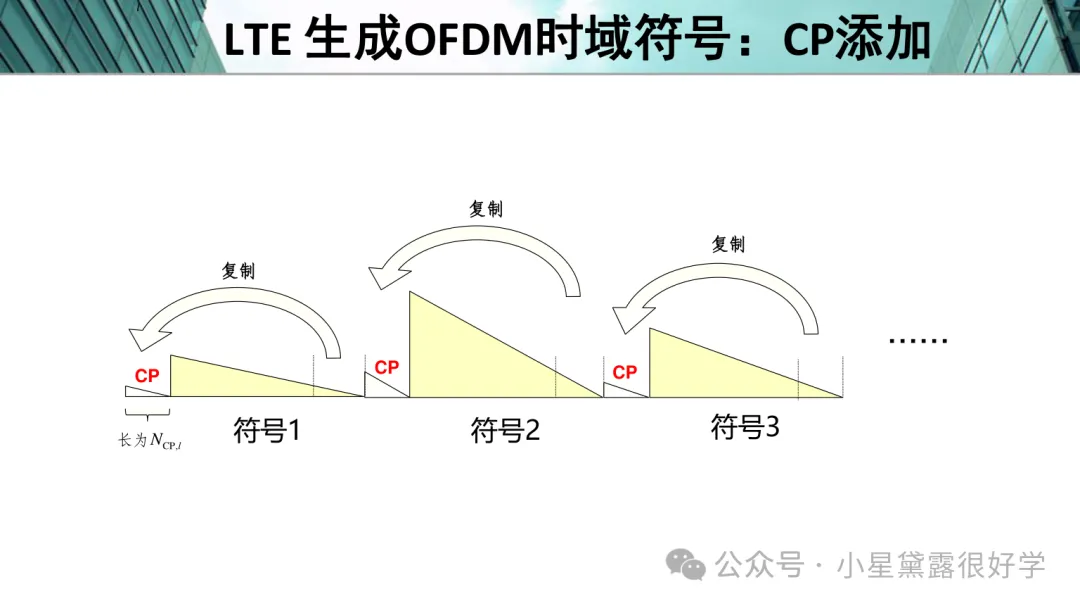
图13 循环前缀的添加方式(来源:Exp.04,第25页)
常规CP配置下,课件给出的长度为:第0号和第7号符号的CP长度为160,其余符号为144。
发射端相关代码的处理顺序为:资源映射到频域 → 频域转换到时域 → 半子载波间隔频移 → 添加CP → 输出天线口信号。
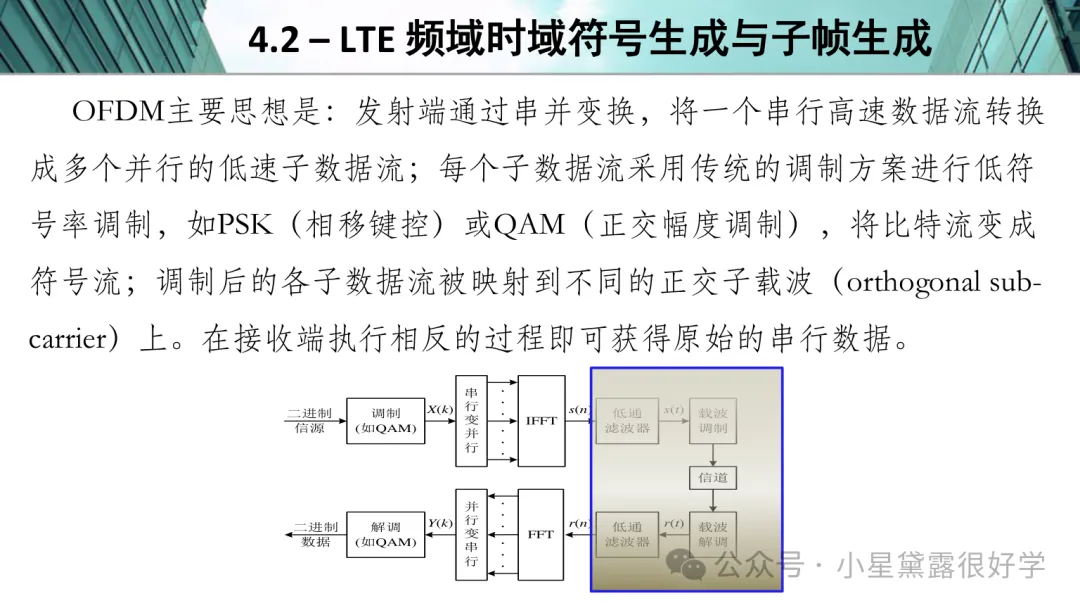
图14 OFDM发射与接收处理流程示意(来源:Exp.04,第14页)
第9题:什么是时间同步?CP法和DMRS法有什么区别?
题目:接收机为什么需要时间同步?请分别说明基于CP和基于DMRS的时间同步原理。
时间同步的任务是确定接收信号的正确起始位置。可以把它理解为找到一段录音从哪里开始,避免从错误位置截取信号。
CP同步法
CP与有效数据中对应的一段内容具有重复关系。接收机可以将接收信号延迟一个FFT长度,计算两段信号之间的自相关;在搜索范围内找到相关峰值,就可以估计符号起点。
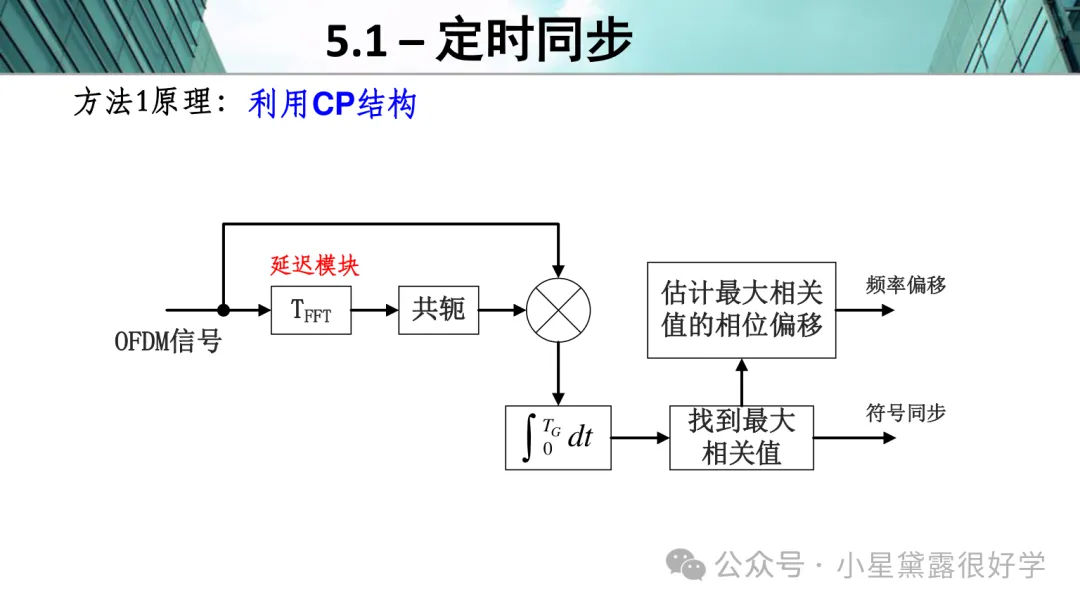
图15 基于循环前缀的定时同步原理(来源:Exp.05,第5页)
DMRS同步法
接收机预先生成本地已知DMRS,与接收信号进行匹配相关。相关值最大的时刻对应最匹配的位置,据此估计信号起点。
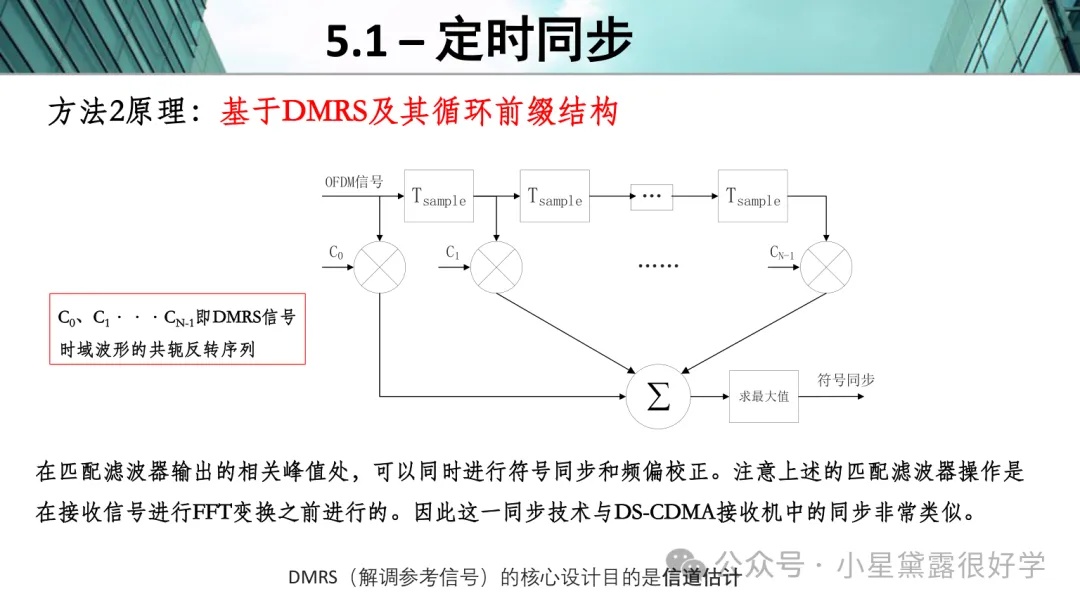
图16 基于DMRS及其匹配滤波的同步原理(来源:Exp.05,第11页)
比较 | CP法 | DMRS法 |
使用信息 | 循环前缀的重复结构 | 已知导频序列 |
核心操作 | 自相关 | 与本地序列互相关 |
主要特点 | 利用信号自身重复结构 | 利用已知参考序列匹配 |
接口:[syncRxSig, dlyEst, corRes, corPow] = ulrx_sch_symSync(chSig, mode)。mode=1表示CP法,mode=2表示DMRS法。
考试参考答案:时间同步用于确定接收信号的正确起始位置。CP同步利用循环前缀与有效信号之间的重复结构进行自相关;DMRS同步利用接收信号与本地已知导频进行互相关,通过相关峰值确定同步位置。
第10题:什么是频偏?小数频偏和整数频偏有什么区别?
题目:发射机和接收机之间为什么会存在频率偏移?什么是小数频偏和整数频偏?为什么需要分两步进行估计和补偿?
CFO(Carrier Frequency Offset,载波频率偏移)是发射端和接收端载波频率不一致造成的偏差。课件将归一化频偏表示为:
Δf = (m + ε) fsc
m为整数频偏,ε为小数频偏,fsc为子载波间隔。例如Δf=3.25fsc,则m=3、ε=0.25。
小数频偏会破坏子载波正交性,引起ICI(载波间干扰);整数频偏会使频域数据整体发生子载波位置偏移。
小数频偏估计
课件介绍了基于CP重复结构的延迟自相关方法:
R = Σ r(n) r*(n + D)
ε̂ = −angle(R) / 2π
例如angle(R)=−π/2,则ε̂=0.25。
整数频偏估计
先补偿小数频偏,再转换到频域,利用接收导频与本地导频进行互相关,根据导频位置的整体偏移量估计整数频偏。
代码中ffo_est表示小数频偏估计结果,ifo_est表示整数频偏估计结果。处理顺序是先小数频偏补偿,再整数频偏估计与补偿。
考试参考答案:频偏分为整数频偏和小数频偏。小数频偏破坏子载波正交性并造成ICI;整数频偏使频域数据发生整体子载波偏移。接收机先利用CP自相关估计和补偿小数频偏,再通过导频互相关估计和补偿整数频偏。
第11题:什么是信道估计?如何进行信道补偿?
题目:已知发射机发送的导频为X[n],接收机接收到的导频为Y[n],写出信道估计公式,并说明如何利用估计结果进行补偿。
信道会使信号幅度变小、相位发生旋转。接收信号模型可写为:
Y[n] = X[n]H[n] + N[n]
在忽略噪声的简单情况下,利用接收机已知的导频可以估计信道:
Ĥ[n] = Y[n] / X[n]
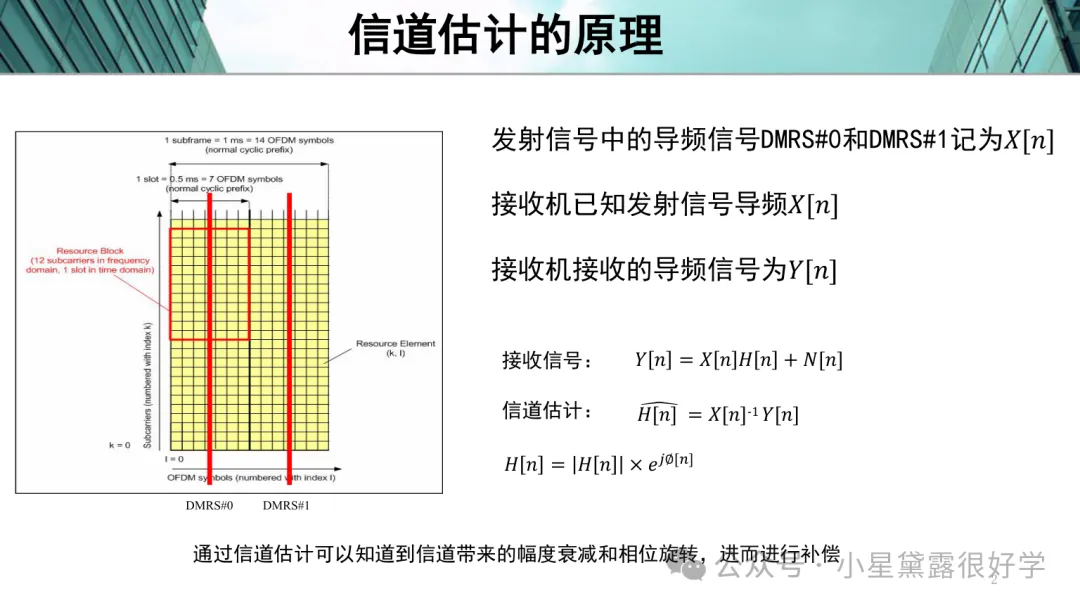
图17 基于导频的信道估计模型(来源:Exp.06,第2页)
例如X=2、Y=1,则Ĥ=0.5,表示接收信号幅度变为原来的50%。
线性插值
由于并非每个符号都有导频,可以利用两个已知导频位置之间的信道估计值进行线性插值:
Ĥ(l)=Ĥ(l₀)+(l−l₀)/(l₁−l₀)·[Ĥ(l₁)−Ĥ(l₀)]
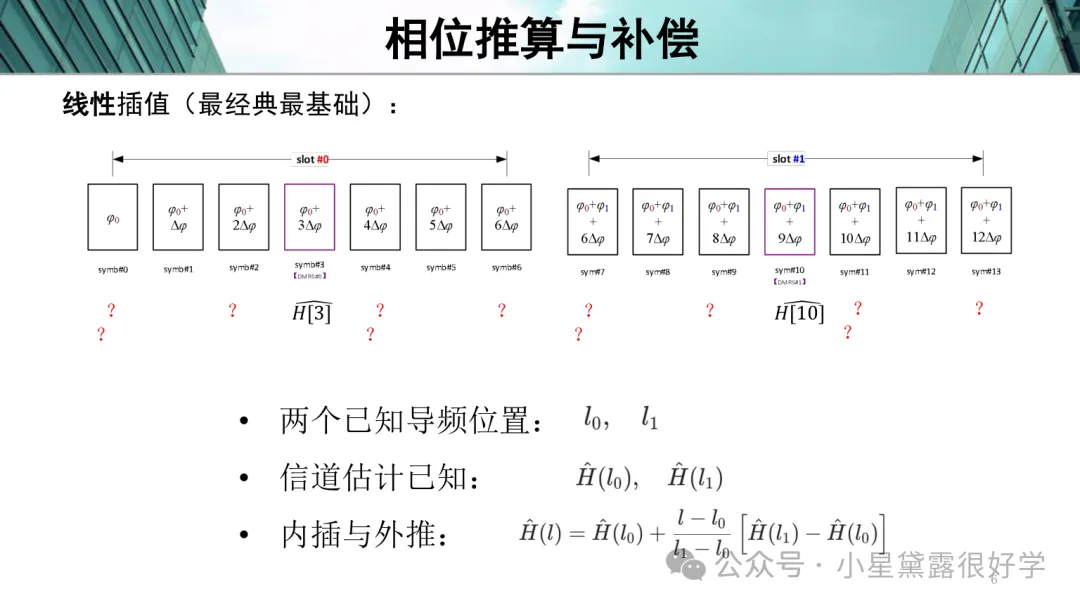
图18 两个导频位置之间的线性插值示意(来源:Exp.06,第6页)
例如l₀=3、l₁=10,Ĥ(3)=0.5、Ĥ(10)=1,则Ĥ(5)=0.5+(2/7)×0.5≈0.643。
ZF与MMSE均衡
ZF: X̂ = Y / Ĥ
MMSE: X̂ = Ĥ*Y / (|Ĥ|² + σn²/σx²)
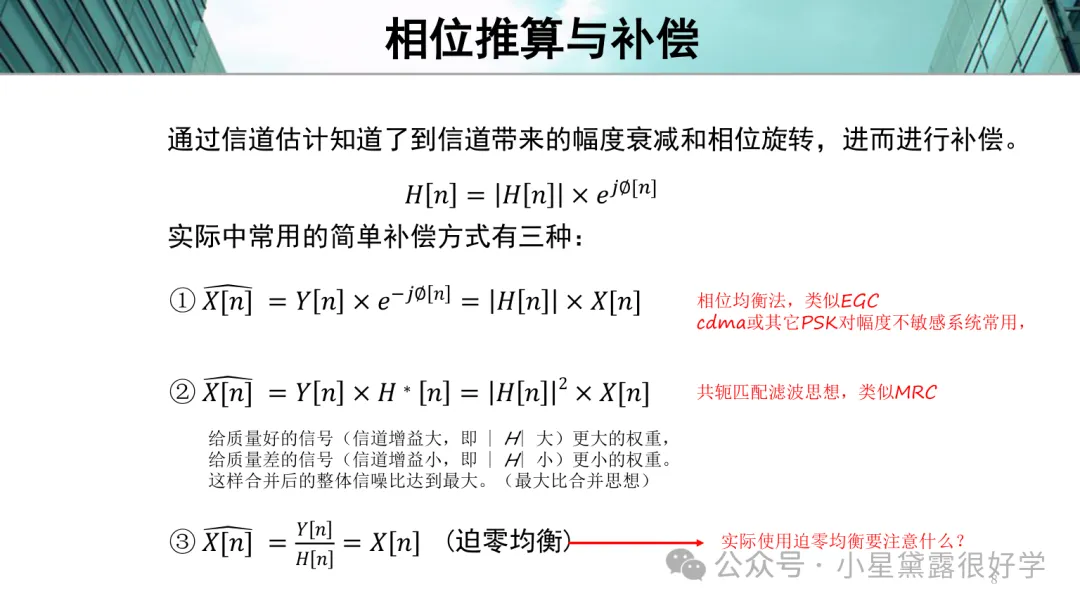
图19 ZF与MMSE均衡公式及特点(来源:Exp.06,第8页)
ZF直接除以信道估计值;当信道增益很小时,可能显著放大噪声。MMSE则同时考虑信道和噪声影响,通常更加稳健。
考试参考答案:信道估计利用接收端已知的导频信号,估计无线信道对信号造成的幅度衰减和相位变化。最基本的估计方法为Ĥ=Y/X。获得信道估计后,可通过ZF或MMSE等均衡方法补偿信道影响。
第12题:如何理解64QAM解调代码?它是硬解调还是软解调?
题目:分析以下MATLAB代码,说明其功能,并判断采用的是硬解调还是软解调。
M = 64; symbol_idx = qamdemod(r, M); bits_out = de2bi(symbol_idx, 6, 'left-msb');
第一行M=64表示采用64QAM。第二行qamdemod将接收到的复数信号r映射为0至63之间的星座点整数索引。第三行de2bi将整数索引转换成6位二进制,left-msb表示最高有效位在左侧。
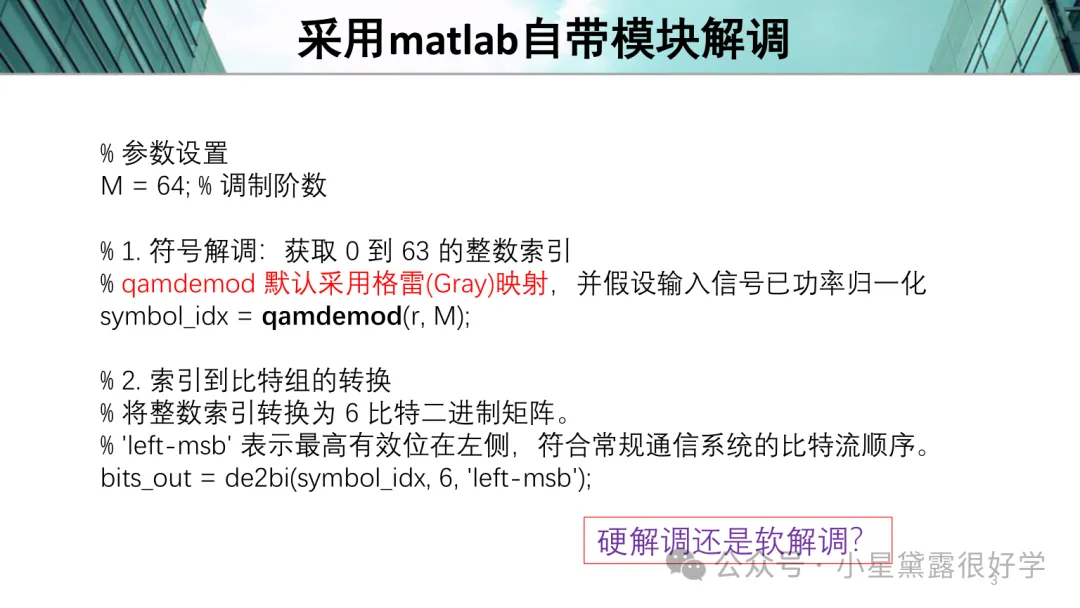
图20 MATLAB 64QAM硬解调代码(来源:Exp.07,第3页)
该代码属于硬解调:它直接输出确定的星座点索引和比特0/1,没有保留每个比特的可信程度。软解调则会输出软信息,例如LLR,供后续译码使用。
考试参考答案:代码先利用qamdemod获得0至63之间的整数星座索引,再通过de2bi转换成6位二进制比特。由于没有保留比特的软判决信息,因此属于硬解调。
第13题:什么是SER?如何评价通信系统性能?
题目:说明SER的含义,以及如何通过改变SNR评价通信系统性能。
SER(Symbol Error Rate,符号错误率)是接收端判断错误的符号数占总发送符号数的比例。
SER = 错误符号数 / 总发送符号数
例如发送100个符号,其中5个判断错误,则SER=5/100=0.05。
BER统计错误比特数占总比特数的比例;SER统计错误符号数占总符号数的比例。一个64QAM符号包含6 bit,只要其中任意一位出错,该符号就算错误。
SNR是信噪比。一般而言,SNR越高,噪声相对越小,SER通常越低。
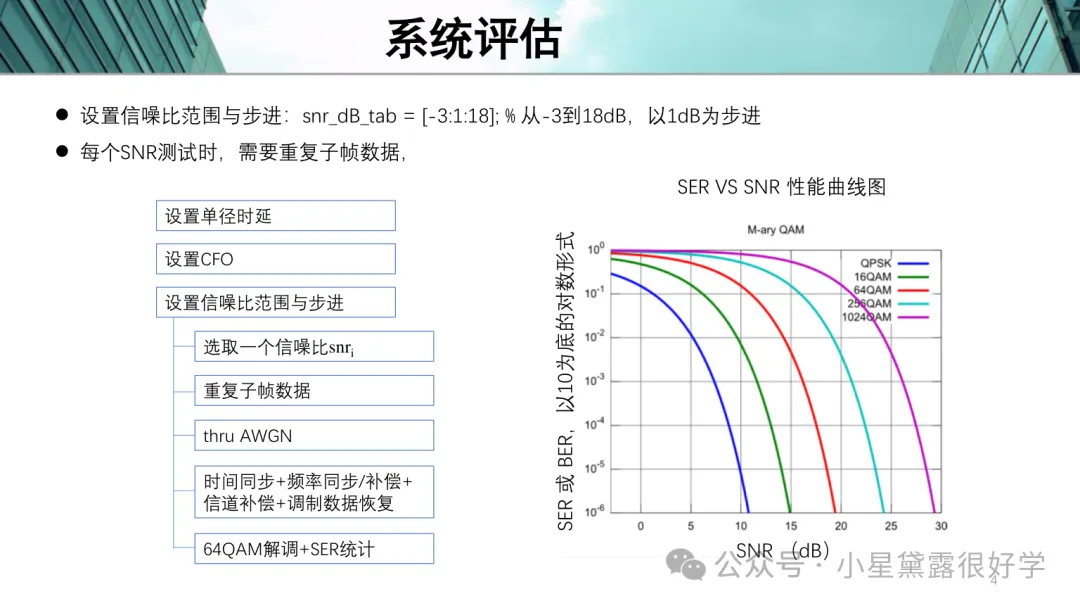
图21 系统级性能评估流程及SER-SNR曲线(来源:Exp.07,第4页)
课件示例代码设置snr_dB_tab = -3:1:18,表示SNR从−3 dB到18 dB,每次增加1 dB。对每个SNR重复信号传输、同步、补偿和解调,并统计SER,最终绘制SER与SNR的关系曲线。
考试参考答案:SER是符号错误率,表示接收端判断错误的符号数占总发送符号数的比例。通过改变SNR并重复收发过程,统计不同SNR下的SER,可以评价系统性能。一般SNR越高,SER越低。
五、流程图与伪代码:算法设计题怎么答?
接收机算法设计题通常要求说明输入、初始化、循环处理、判断、更新和输出。重点是把算法步骤讲清楚,不必一开始就写出复杂的MATLAB程序。
示例题:设计一个基于CP的时间同步算法
题目:请设计一个基于CP的时间同步算法,画出流程并写出伪代码。
算法思路
1.输入经过信道后的接收信号chSig。
2.设置搜索起点、搜索范围和最大相关值。
3.遍历可能的时间位置,提取当前位置的信号。
4.利用CP与延迟一个FFT长度后的对应信号计算自相关值。
5.如果当前相关值大于已记录的最大相关值,则更新最大相关值并记录当前位置。
6.搜索结束后,输出最大相关值对应的位置,作为同步时延估计。
伪代码示例:
输入:接收信号 chSig 初始化:maxCorr = 0,delayEst = 0 遍历所有可能的时间位置: 取当前位置的信号 将信号延迟一个 FFT 长度 计算 CP 与对应信号的相关值 如果当前相关值大于 maxCorr: 更新 maxCorr 记录当前位置 delayEst 结束循环 输出 delayEst
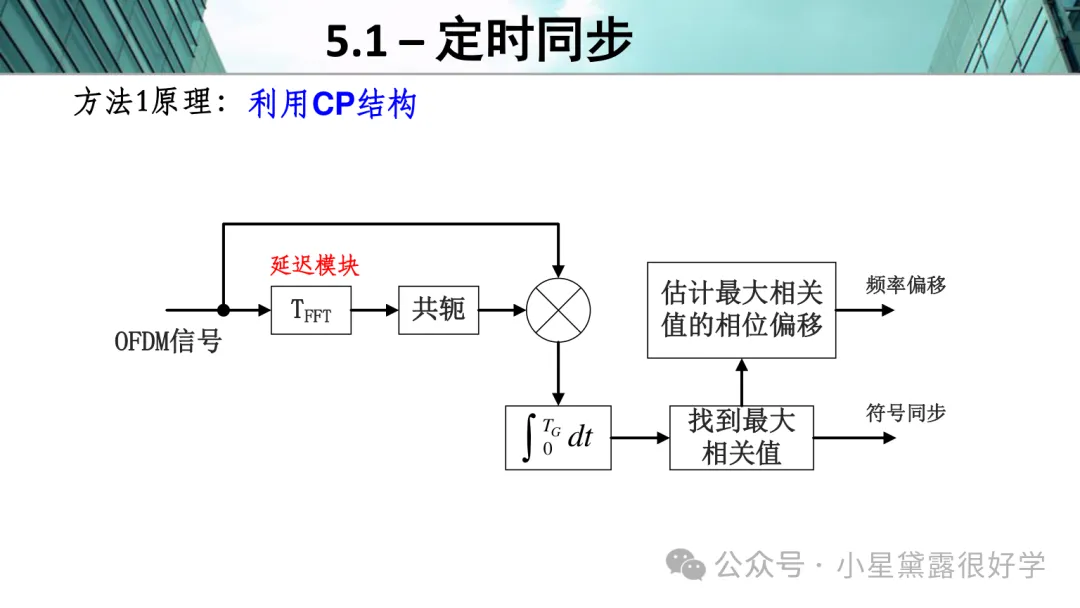
图22 CP同步算法的原理参考图(来源:Exp.05,第5页)
通用答题模板:输入信号 → 初始化参数 → 循环计算 → 判断条件 → 更新变量 → 输出结果。这个结构也可用于理解频偏估计、信道估计和线性插值等算法。

