复习越久考越高?用简单线性回归预测你的考试分数(含SPSS操作和R代码分享)
- 2026-10-14 12:42:55
复习越久考越高?用简单线性回归预测你的考试分数(含SPSS操作和R代码分享)🧠 一起长脑子 Lab · SPSS新手系列 第 2 期 复习越久考越高?用简单线性回归预测你的考试分数 💡 文末有 统计工具套装(方法选择+SPSS操作速查) 免费领取方式,记得看到最后 🎁 📚 案例设定:20个学生的复习追踪
描述统计:复习时长 M = 9.05h(SD = 3.78,范围3–16h);考试分数 M = 73.50(SD = 10.40,范围55–90)。Pearson相关 r = .985,p < .001,呈极强正相关。 🔍 前提判断:线性回归的4个假设
💡 新手建议:先画散点图确认线性关系,再跑回归。如果散点明显弯曲,线性回归就不合适,得换方法。 🛠️ 操作实战:SPSS + R 双版本 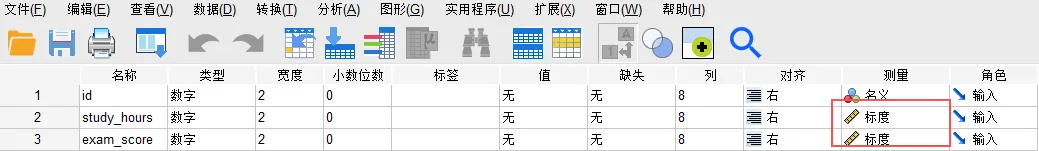
复习时长(小时)和考试分数(0-100)类型设为数值,度量标准设为标度 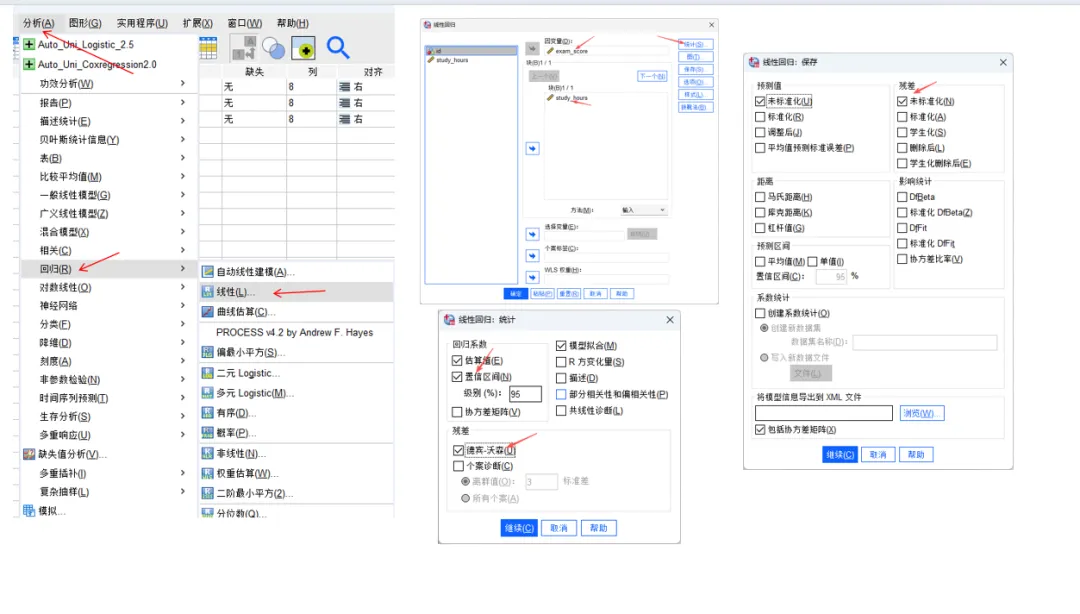
习时长放入「自变量」,统计里勾选「置信区间」 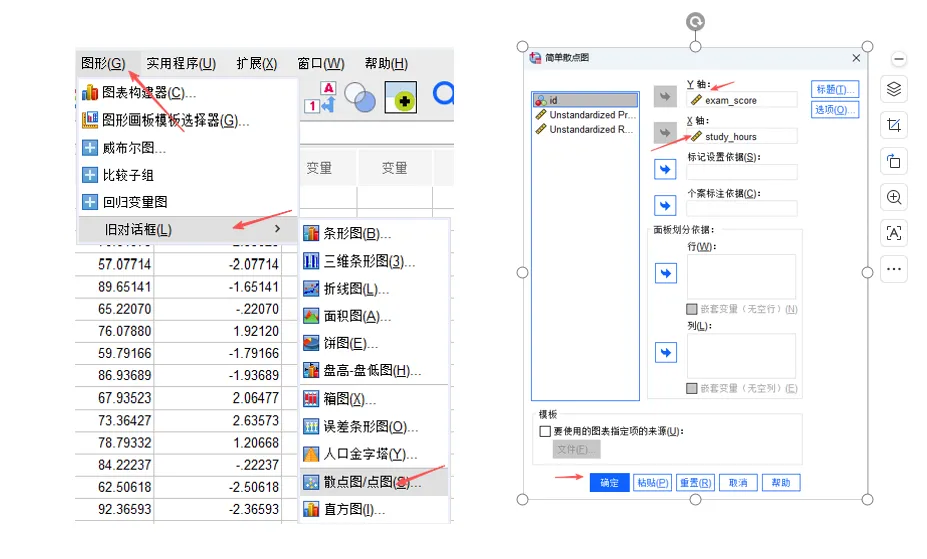
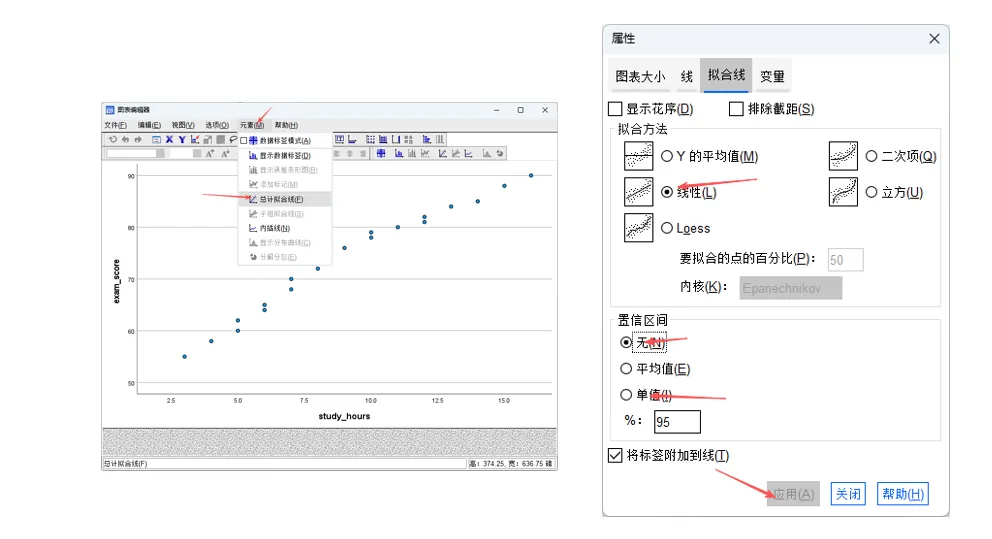
图形 → 旧对话框 → 简单散点图;出图后双击进入图表编辑器 → 元素 → 总计拟合线 ; 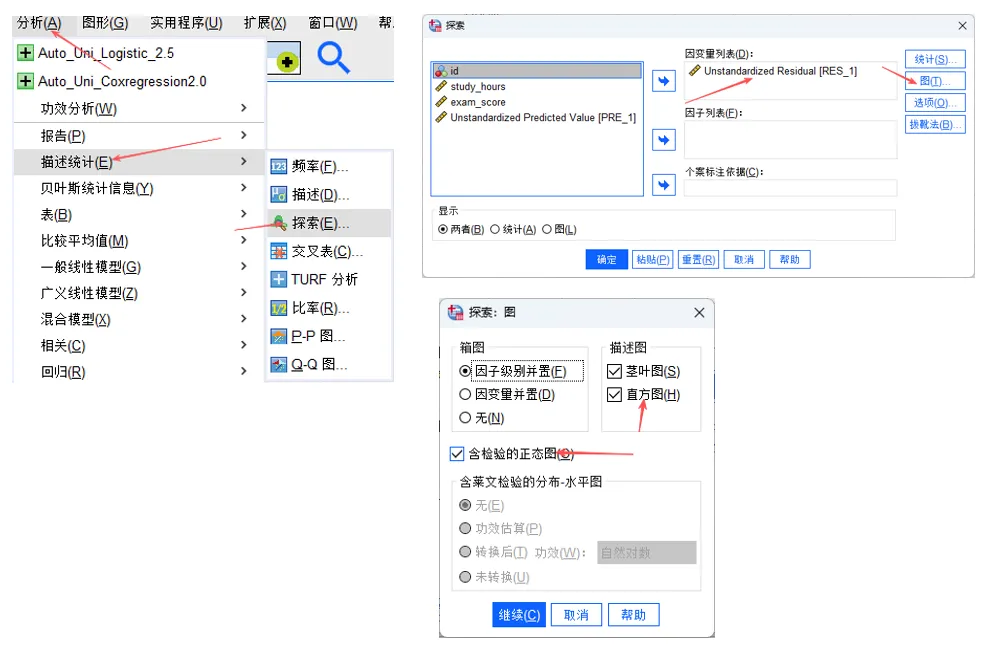
残差进行生态性检验 # 1. 读取数据data<-read.csv("E:/公众号专用/复习时长数据.csv", header = TRUE, fileEncoding = "UTF-8")# 2. 查看结构str(data)head(data)# 3. 散点图(确认线性关系)plot(data$study_hours, data$exam_score, xlab = "复习时长(小时)", ylab = "考试分数", pch = 16, col = "#6c5ce7", cex = 1.3)abline(lm(exam_score ~ study_hours, data = data), col = "#e74c3c", lwd = 2)# 4. 简单线性回归model<-lm(exam_score ~ study_hours, data = data)summary(model)# 5. 残差检验plot(model, which = 1) # 残差 vs 拟合值(方差齐性)plot(model, which = 2) # Q-Q图(残差正态性)# 6. 置信区间confint(model, level = 0.95) 💡 新手提示:CSV列名用英文(如 📊 读结果:三个表各看什么 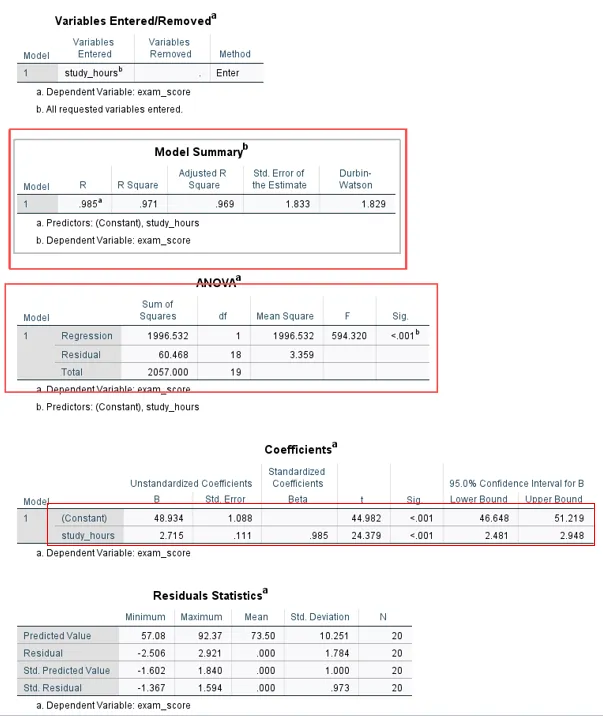
重点看「模型摘要」的R²和「系数」表的B值、p值 人话结论:回归方程 Y = 48.93 + 2.715X。不复习预计考约49分,每多复习1小时预计涨2.715分。模型解释了97.1%的分数差异(R²=.971),整体极显著(F=594.32, p<.001)。这组数据是理想化的教学示例——真实研究中分数还受基础、题目难度、临场状态影响,R²通常没这么高,但回归的"多一个单位变多少"这个逻辑是完全一样的。 🚫 避坑指南:四个新手必踩的雷 雷区1:把相关当回归用相关只告诉你"有关系",回归能告诉你"多一个单位,变多少"。想预测分数,必须用回归。 雷区2:忽略散点图直接回归如果关系不是直线(比如复习10小时以内分数涨得快,超过10小时反而下降),线性回归会给出误导性结果。先画图! 雷区3:外推预测数据范围是复习3–16小时,你就只能在这个范围内预测。别拿模型去预测"复习50小时能考多少"——超出数据范围,回归线早就失效了。 雷区4:别被超高的R²迷惑本例R²=.971很漂亮,但这是理想化教学数据。真实研究中如果R²接近1,先检查是不是数据被"洗"过(比如只保留规律明显的样本)。真实教育数据的R²通常在0.3–0.6,能用回归说明趋势,不必追求极致拟合。 📋 论文汇报模板(直接抄):以考试分数为因变量、复习时长为自变量进行简单线性回归。结果显示,复习时长对考试分数有显著正向预测作用(B = 2.715, β = .985, p < .001),模型解释率 R² = .971, F(1,18) = 594.320, p < .001。 🎁 免费领取 统计工具套装 很多新手不是不会点SPSS,而是不知道该用哪种方法。 🔍 统计方法选择工具 → 5个问题帮你选对方法 🛠️ SPSS操作步骤速查工具 → 选完方法直接查菜单路径+决策树+汇报模板 关注「一起长脑子 Lab」公众号 后台回复 「SPSS工具」 两个工具一起发给你 📥 学到这里卡住了?或者有想学的方法我们还没讲到?评论区甩出来,师兄师姐给你提前安排 💪
期末前一周,你室友每天泡图书馆,你问他「复习20小时能考多少分」,他说「不知道,但感觉有用」。作为一个学过统计的人,你不能只靠感觉——你要建个模型,精确预测。
这就是本期要讲的方法:简单线性回归(Simple Linear Regression)。一个自变量(复习时长)预测一个因变量(考试分数),输出一条回归线,告诉你「多复习1小时,分数预计涨多少」。
我们收集了20名大学生《统计学》期末考试的数据:
很多新手跳过前提检验直接跑回归,结果出来自己都不敢用。简单线性回归有4个前提,前两个必查:
SPSS路径 分析 → 回归 → 线性
R语言代码(从CSV导入,精简版,复制即跑)
相对于SPSS的点选操作,R语言只需几行代码就能完成全部分析,效率极高。
study_hours, exam_score)避免编码报错。summary(model) 会一次性输出回归系数、R²、F检验和p值,够写报告用了。表1:模型摘要
看 R²——本例 R² = .971,意味着复习时长解释了97.1%的分数差异,估计标准误仅1.833,模型拟合度极高。
表2:ANOVA
看 F检验——F = 594.320,p < .001,整个回归模型极显著,说明复习时长对分数的预测作用绝非偶然。
表3:系数
看两个核心值:• 常数项 B = 48.934(SE=1.088,t=44.98):当复习时长为0时的预计分数,即完全不复习大约考49分。• study_hours B = 2.715(SE=.111,t=24.379,p < .001):每多复习1小时,预计分数增加2.715分,标准化Beta=.985。• 95%置信区间 [2.481, 2.948]:区间远离0,进一步佐证显著。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

