LASPAI用户复习相关功能模块的方法学论文
- 2026-09-19 18:23:19
论文提出的方法解决什么问题
过渡态(TS)搜索有两类做法:chain-of-states(NEB等)与 surface-walking。P-RFO这类方法在有解析Hessian时最快,但非高斯基组的量子力学程序里二阶导很贵,复杂体系自由度一多,算法还容易发散。dimer 方法不需要 Hessian,但原版旋转一次要4次能量+梯度计算、且「一旋一移」的框架在大步长下很不稳。
这篇论文提出的三个改动
- 旋转
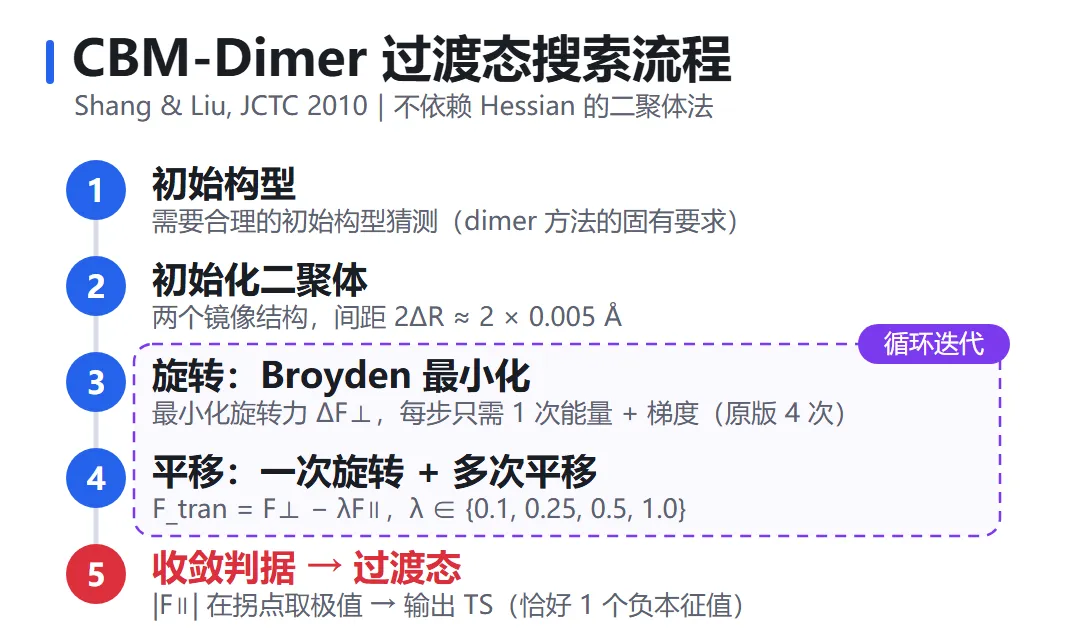
用准牛顿 Broyden 最小化旋转力ΔF⊥,只需 1 次能量+梯度就能定出旋转角(原版4次,Olsen近似后2次)。 - 平移
改「一次旋转 + 一次平移」为「一次旋转 + 多次平移」,用Broyden迭代历史近似法向模式连续走。 - 轨迹控制
F_tran = F⊥ − λF∥(式 14),λ∈[0,1] 按 rms |F∥| 分四档(0.1/0.25/0.5/1.0);C>0 区再加 0.5 前因子。终止判据是 |F∥| 在拐点取极值(式 13/17)。
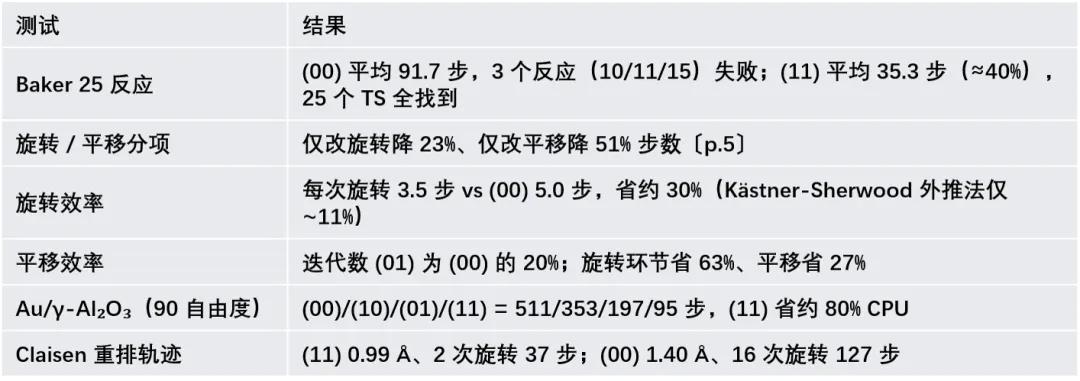
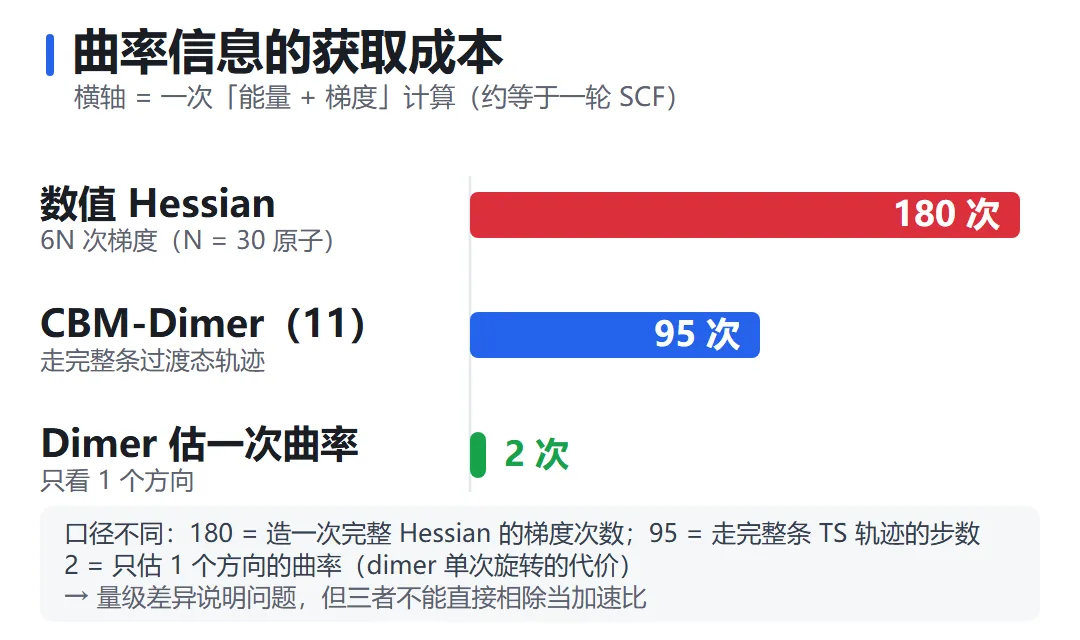
(00)=CG-dimer 原版,(10)=只换旋转,(01)=只换平移,(11)=本文新方法。- 作者承认的局限
dimer类方法有dead-end valley问题,仍需要合理的初始构型猜测;改进后 Baker 体系平均步数仍是 P-RFO + 解析Hessian的约两倍,优势只在大体系;λ 四档与0.5前因子是「方便选取」的经验值,无敏感性分析。
Hessian就是这篇论文里那个贵到不想算的东西。先看它的物理含义——曲率。
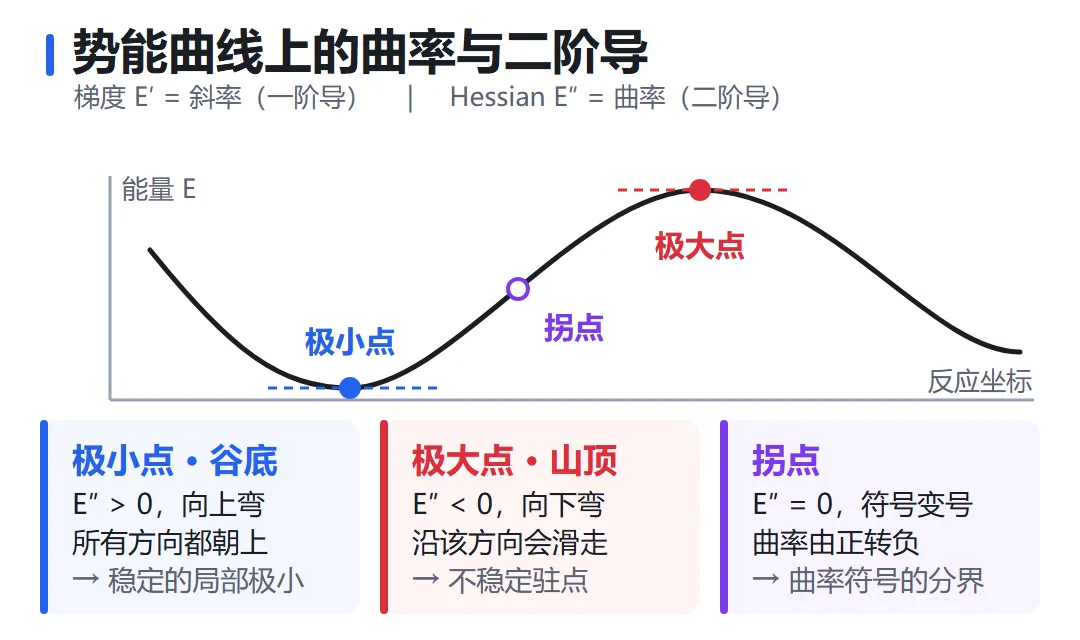
定义:能量 E 对全部核坐标求二阶偏导,排成矩阵就是Hessian
H_ij = ∂²E / ∂x_i ∂x_jN个原子的体系有3N个坐标,所以 Hessian 是3N × 3N的对称矩阵。30个原子的体系就是 90 × 90——如果按 3N×3N 显式存储,论文里那个Au/γ-Al₂O₃ 体系(90 自由度)要存8100个数。
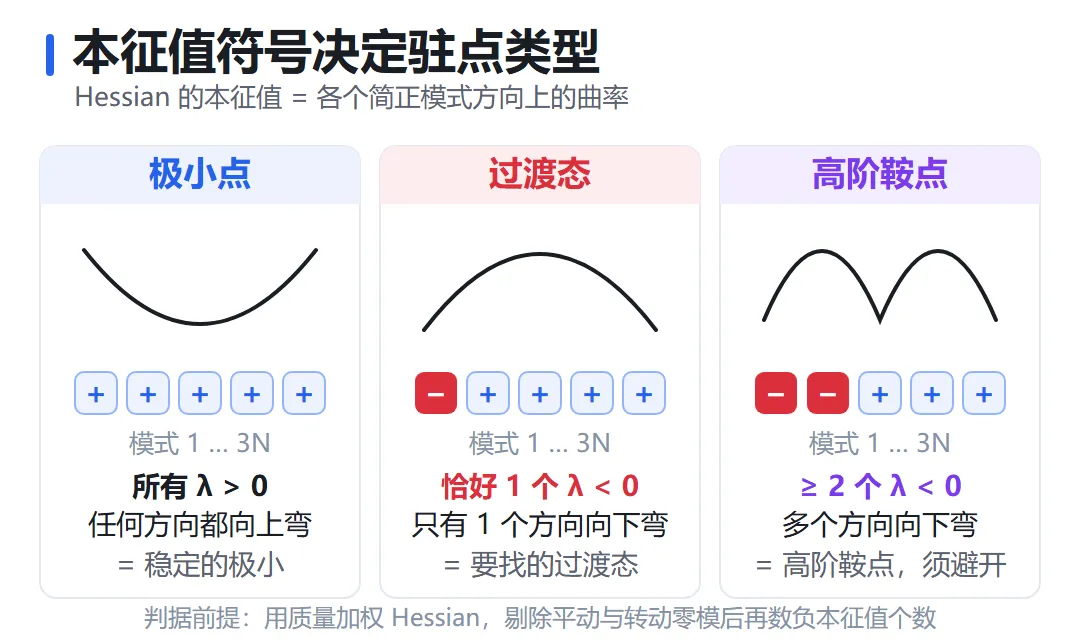
一维时它退化成 E″(x):谷底为正、山顶为负。多维时"正负"升级成本征值符号——Hessian 的本征值就是沿各个简正模式(normal mode)的曲率。
Hessian 贵在哪?它要靠一阶导(梯度)一个个差分出来。
解析二阶导(CPSCF 之类)在平面波 / 数值原子轨道程序里往往不提供或代价极高——这正是论文强调的非高斯基组困境。退而求其次的数值 Hessian:把每个坐标分别正负位移一次,各算一次梯度,3N 个坐标就是 6N 次梯度计算。
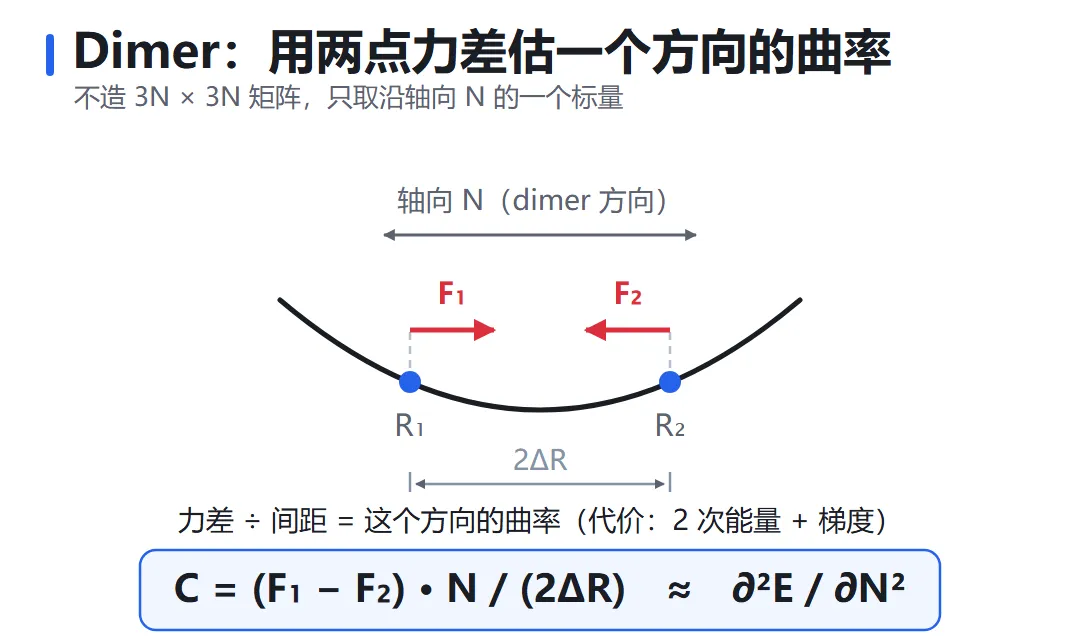
dimer 怎么用一个标量代替整个矩阵?
它的做法是在势能面上放两个靠得很近的结构(这就是“二聚体”,英文叫dimer),间距 2ΔR(典型 0.005 Å × 2)。两个结构上的力之差,除以间距,就是沿它们连线方向 N̂ 的曲率:
C = (F₁ − F₂)·N̂ / (2ΔR) ≈ ∂²E/∂N̂²只取一个方向,而不是 3N 个方向。
一个能算的最小例子
一维谐振子 E(x) = ½kx²:
梯度 E′(x) = kx(x=0 处为零 → 驻点)Hessian E″(x) = k= 力常数频率 ω = √(k/m)
这正是Gaussian程序中计算频率的原理——算质量加权 Hessian,本征值开方得频率。无虚频=极小点,有虚频=不是极小点(1 个虚频就是过渡态)。所以做 TS 优化后跑的 Freq,本质就是在验 Hessian 的本征值符号。